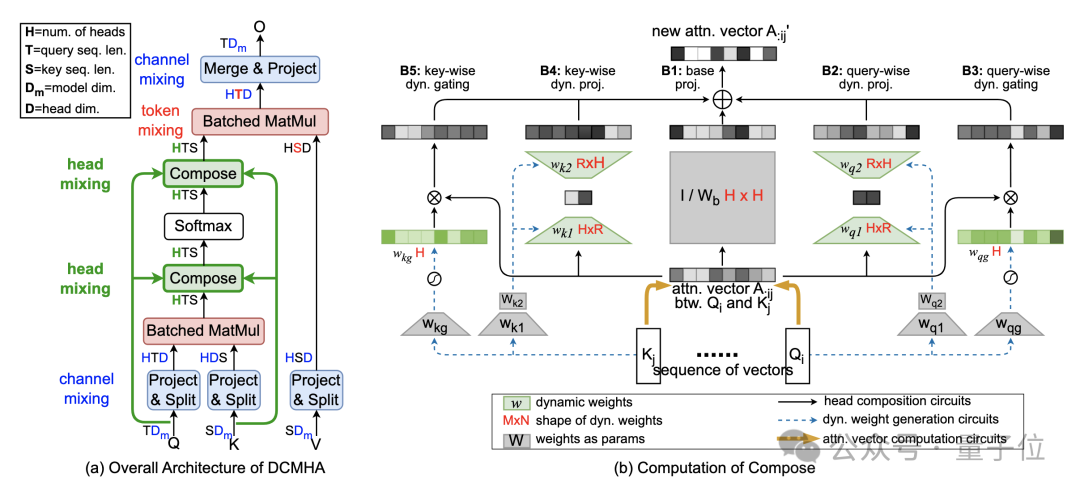
ICML2024高分!魔改注意力,让小模型能打两倍大的模型
ICML2024高分!魔改注意力,让小模型能打两倍大的模型改进Transformer核心机制注意力,让小模型能打两倍大的模型!
来自主题: AI技术研报
10469 点击 2024-06-03 15:44

 搜索
改进Transformer核心机制注意力,让小模型能打两倍大的模型!
本文介绍了香港科技大学(广州)的一篇关于大模型高效微调(LLM PEFT Fine-tuning)的文章「Parameter-Efficient Fine-Tuning with Discrete Fourier Transform」
在大型语言模型的训练过程中,数据的处理方式至关重要。
大模型带来的生命科学领域突破,刚刚再传新进展。