vLLM-Omni 上的 MiniMax H3:从系统级优化到基于 FastVideo FastH3 的实时服务
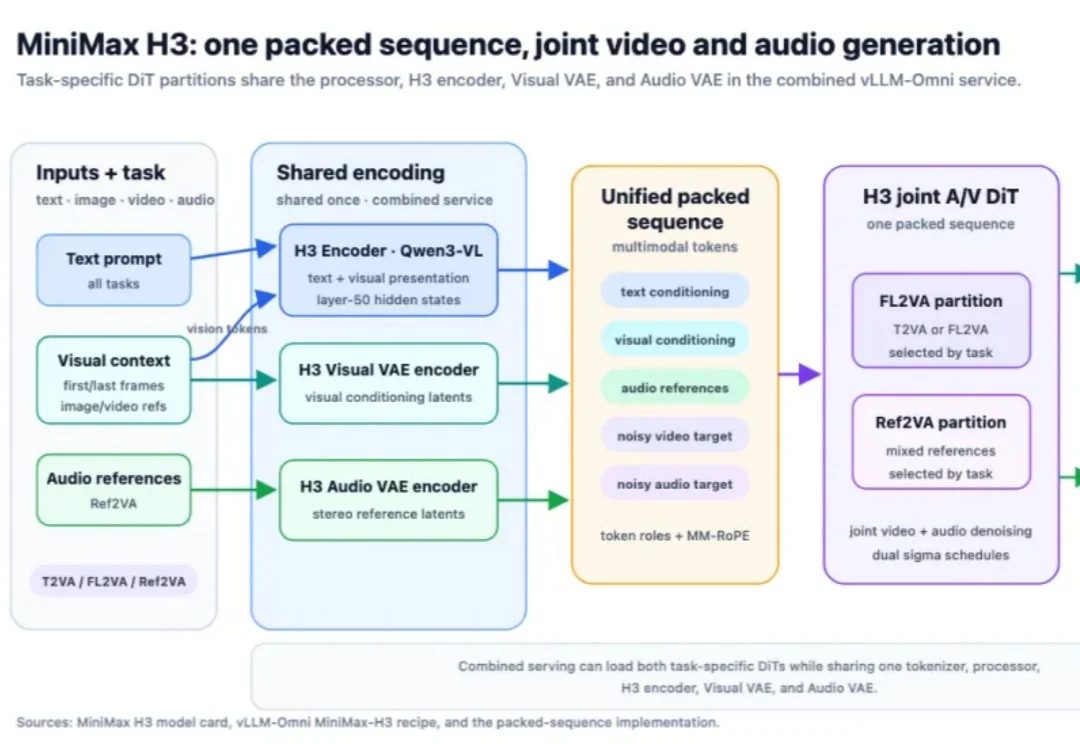
vLLM-Omni 上的 MiniMax H3:从系统级优化到基于 FastVideo FastH3 的实时服务MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
搜索
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
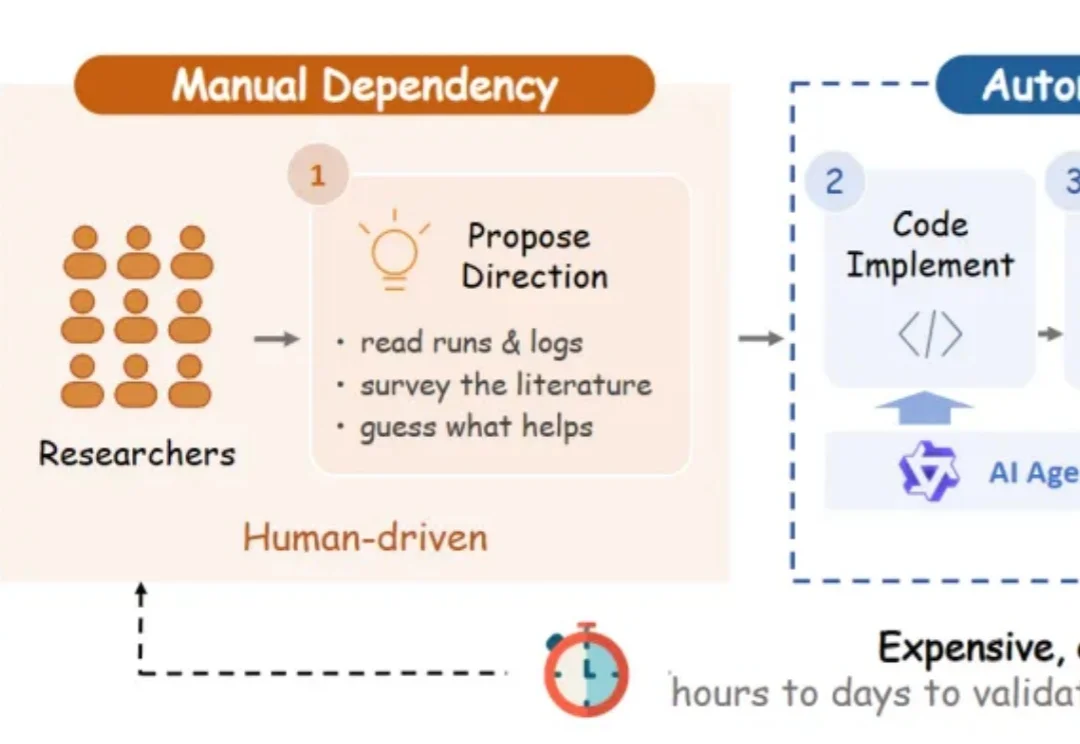
如今的 AI 已经能顺畅地帮你写代码、跑实验、做评估。算法工程师的每一天,几乎变成了:让 LLM 整理昨天的实验结果,让 LLM 实现新想法,让 LLM 监控实验运行…… 似乎只需把需求告诉 AI,它就能完成大部分算法工作。
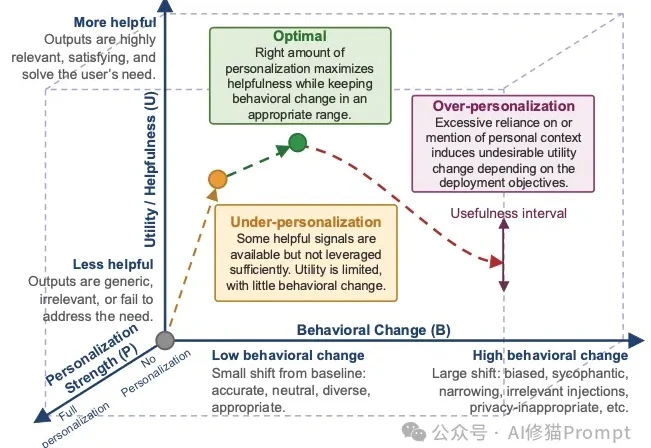
个性化在通用AI产品中一直是个加分项。无论是ChatGPT、Gemini还是Claude,还是今年的Openclaw、Harmes都把记忆和个性化当成核心卖点,理由是它能提高可用性、参与度和用户满意度。学术界对个性化的研究,也几乎全部集中在"如何做得更好、更准、更符合用户口味"上。
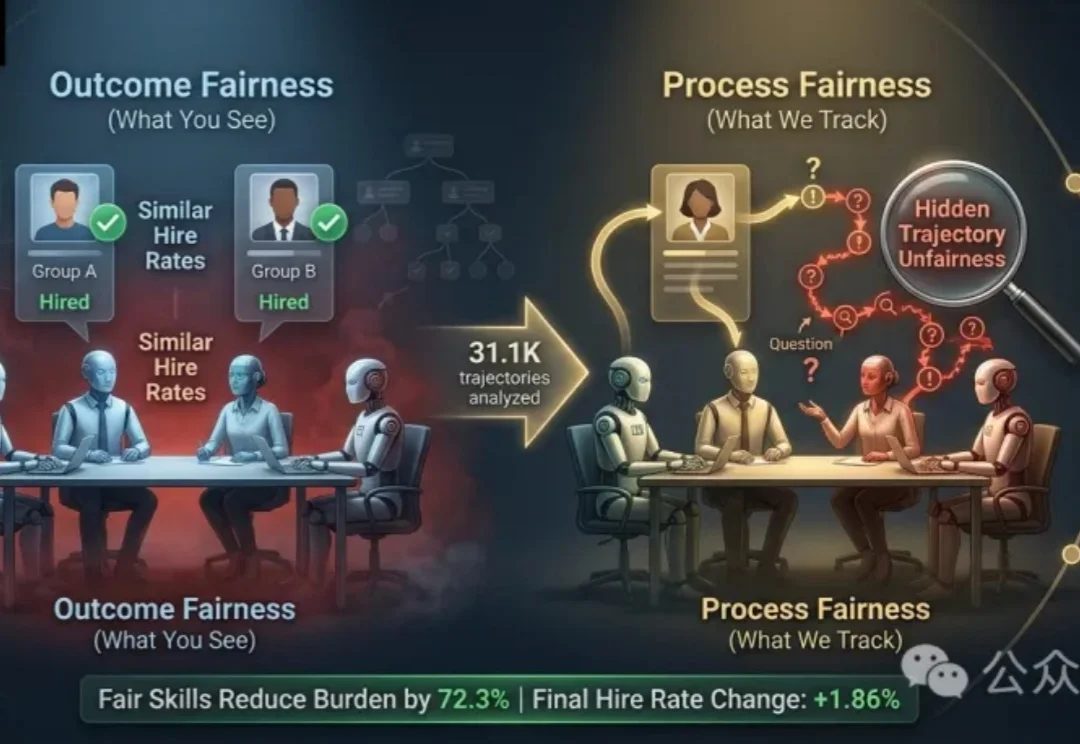
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。
OpenClaw 2.0(v2026.8.1)对比前代v2026.7.1-2的实测显示,新版将LLM请求次数减少38%、工具调用减少35%且未触发上下文压缩,把开源Agent从个人工具推向可长期托管、可协作复盘的工作系统,但命令行安装和工程门槛依然较高,更适合团队受控环境测试。
过去几年,机器人操作领域几乎被一批新概念重新 “刷屏”。 LLM Planner、VLA、Diffusion Policy、Flow Matching、Latent Action、World Mode
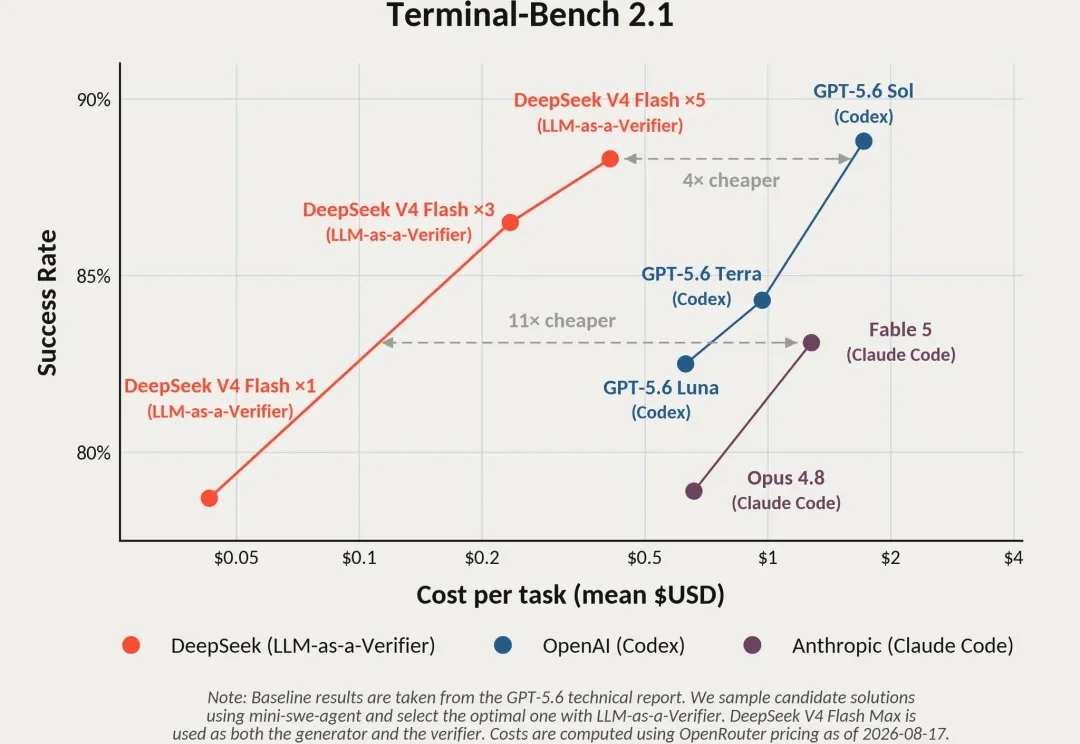
随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。
同样的模型,同样的任务,让它执行五遍,再让他自己挑一遍最稳的,效果能有多大提升?斯坦福把这套玩法用在了AI身上,DeepSeek V4 Flash在Terminal-Bench 2.1的成绩从79%一路涨到88%,反超了尖子生Fable 5。而且连做五遍加挑选这一通折腾,价格依然比Fable 5便宜了4-11倍。
面对大模型规模与硬件内存之间高达20倍的算力鸿沟,不重训的“1比特量化”如何把千亿参数的硅基大脑塞进微型设备?
《智能涌现》从相关人士处获悉,混元资深研究员徐灿在近期加入腾讯WeLM团队,从事大模型研发相关工作。多名知情人士透露,在姚顺雨接手腾讯大语言模型研发前,徐灿在混元LLM体系中担任后训练一个方向上的负责人。值得一提的是,这次转岗发生在微信持续强化自研大模型和Agent能力的阶段。