养大肥鱼只是开始,DeepSeek这10组插件值得装上
养大肥鱼只是开始,DeepSeek这10组插件值得装上文章精选10组仍有近期维护记录的DeepSeek Harness插件,涵盖短剧创作、消息编辑、dsh-pet桌宠、QQ Bot与dsh-wechat手机端任务下达、视频筛选、网页搜索、浏览器操作、办公文件、交互界面、上下文查看及DSH Market插件市场。
来自主题: AI资讯
10090 点击 2026-10-30 15:30

 搜索
文章精选10组仍有近期维护记录的DeepSeek Harness插件,涵盖短剧创作、消息编辑、dsh-pet桌宠、QQ Bot与dsh-wechat手机端任务下达、视频筛选、网页搜索、浏览器操作、办公文件、交互界面、上下文查看及DSH Market插件市场。
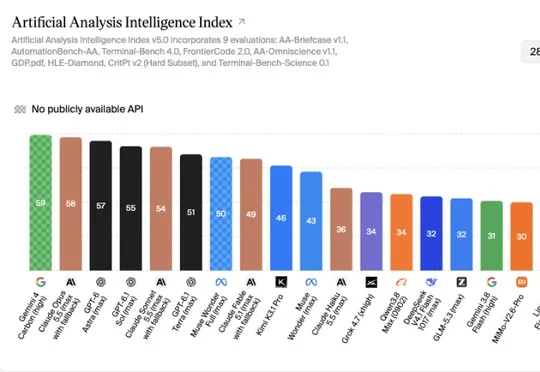
葬AI发起开源Benchmark社区,计划陆续开源真实任务与环境评测Bench,主张国产模型停止刷AA榜并按细分赛道建立自己的标准。
刚刚,用AI最会赚钱的英国人出现了!
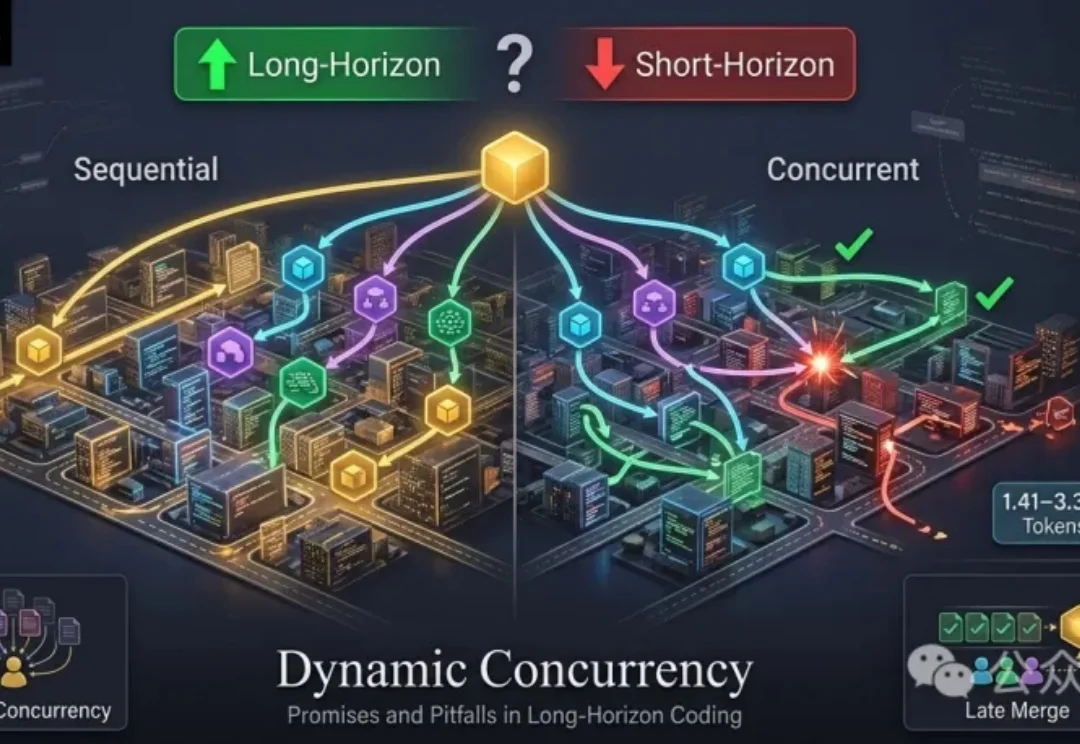
Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。
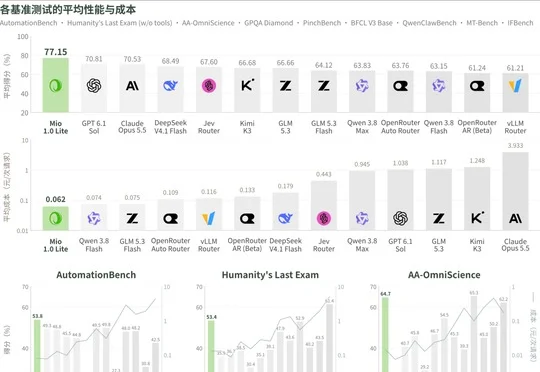
南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。
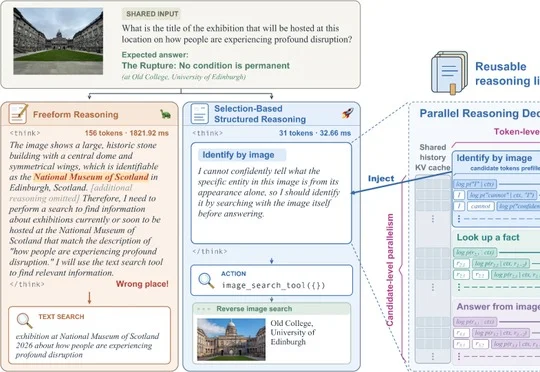
苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。
美国个人AI助理创企Tab公开亮相约六周后估值达3亿美元,但Assistant Benchmark测试显示其预订、旅行和购物任务仍易因网站限制及支付风控失败。
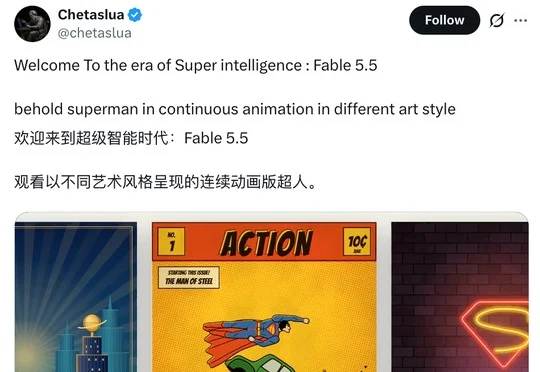
Opus 5.5通过MV、3D游戏和机械沙虫等案例展示出编排完整创作流程的能力,文章指出爆款Demo正成为观察模型的新benchmark,但应结合时间、成本、工具与修改过程判断其成熟度。
Anthropic 为 Claude Code 默认开放可深度改装的 Mods,并推出拥有超 2000 个插件和连接器的 Claude Marketplace,但高权限与暂缺收益分成也带来安全和持续运营疑问。
a16z最新90页报告《STATE OF MARKETS》指出,Alphabet、亚马逊、Meta、微软和甲骨文五家科技巨头2026年合计资本开支预计接近7770亿美元,AI建设正成为影响宏观经济的重要变量,供应链获得订单但回报兑现仍有先后,软件行业则进入"证明自己"的阶段。