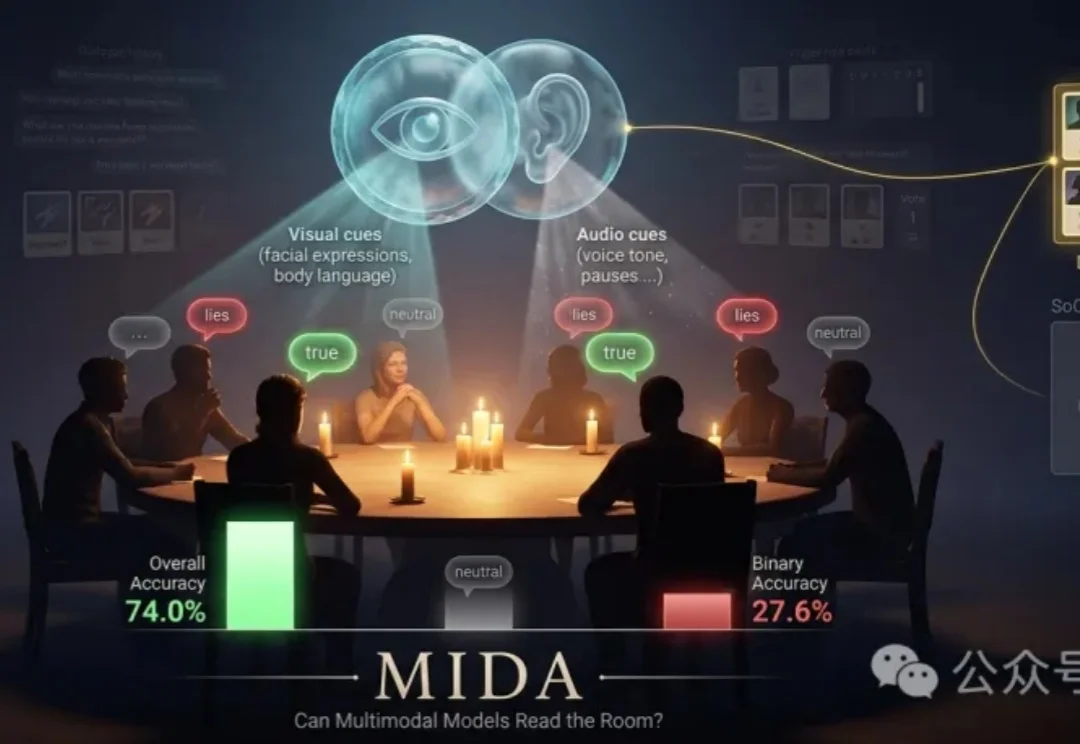
EMNLP'26|GPT也不会「读空气」,狼人杀基准测出社交盲区
EMNLP'26|GPT也不会「读空气」,狼人杀基准测出社交盲区人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
来自主题: AI技术研报
8230 点击 2026-10-29 11:09

 搜索
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
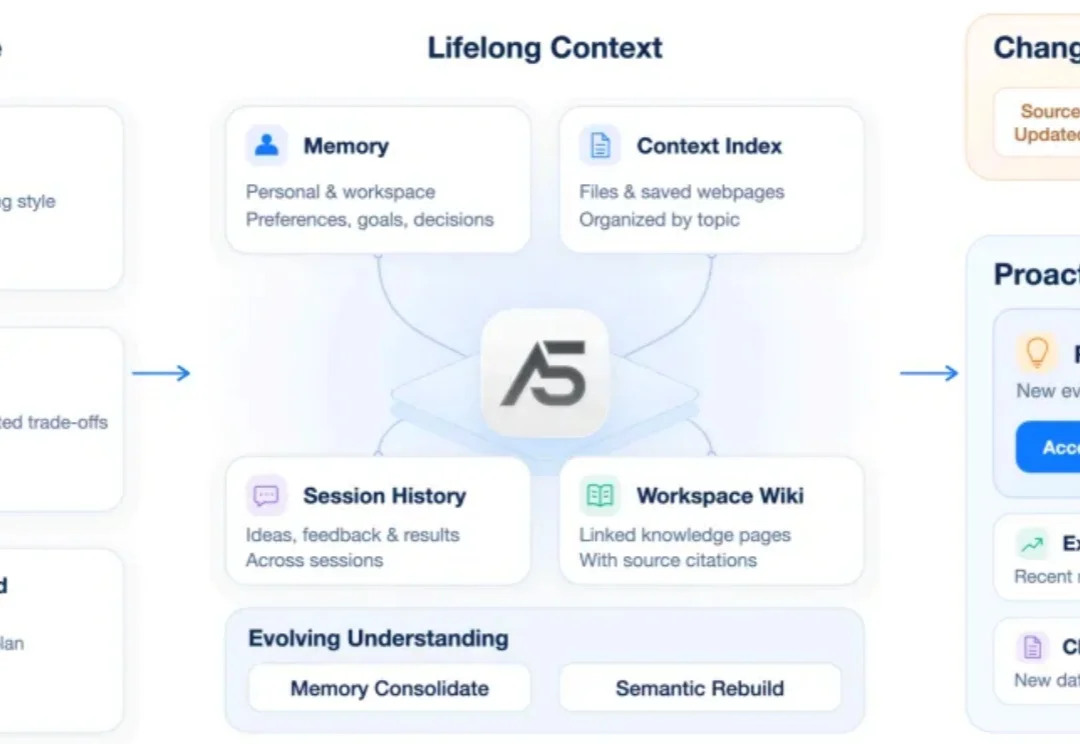
AI 写文章,往往黑话连篇、充满防御性。你费尽心思才让 AI “说人话”,可一旦新开一个对话,先前调好的语言风格就如奶油般化开,熟悉的 AI 味又卷土重来了。
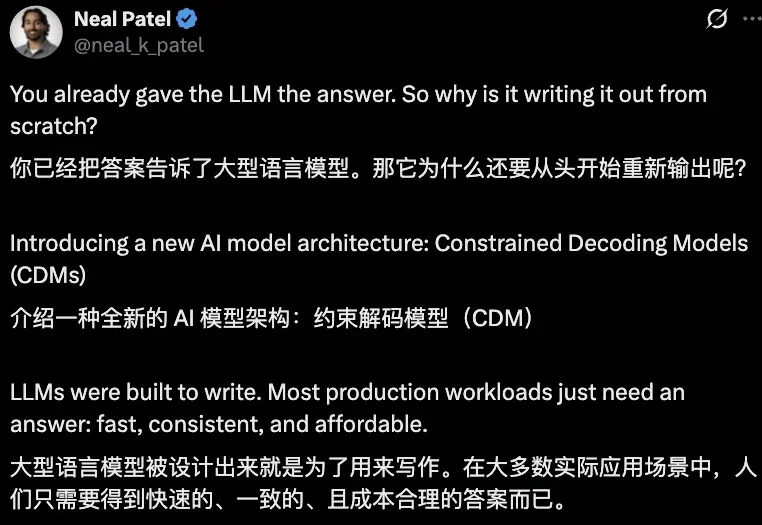
AI圈真是风水轮流转!
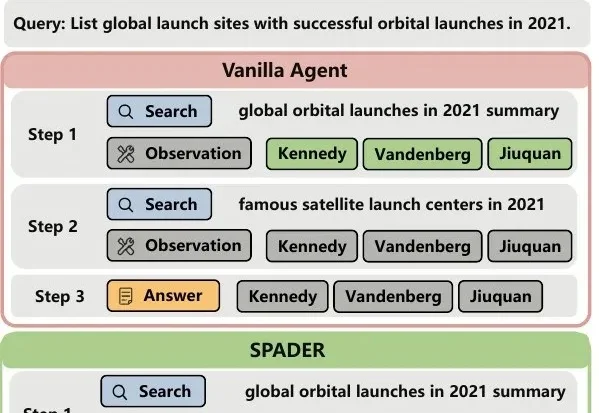
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。
清华大学THUNLP实验室联合面壁智能、OpenBMB等团队开源智能体操作系统PilotDeck 2.0,支持记忆可查可改、后台长任务与智能路由,并在复杂任务测试中将成本降低约83%。
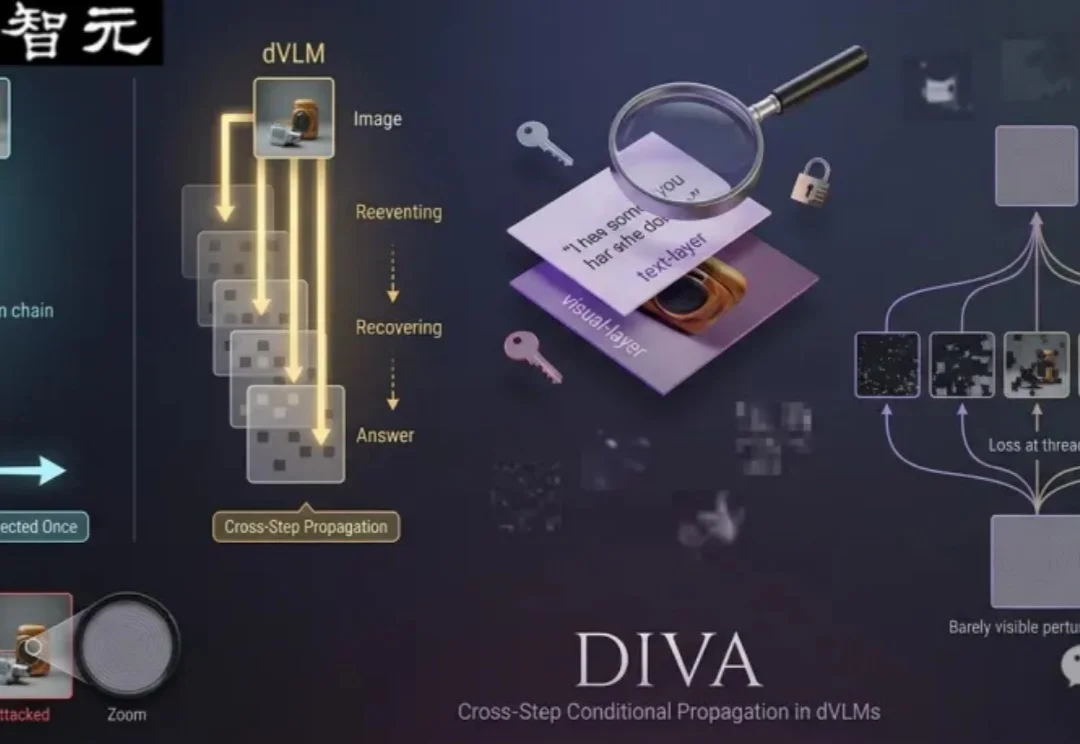
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
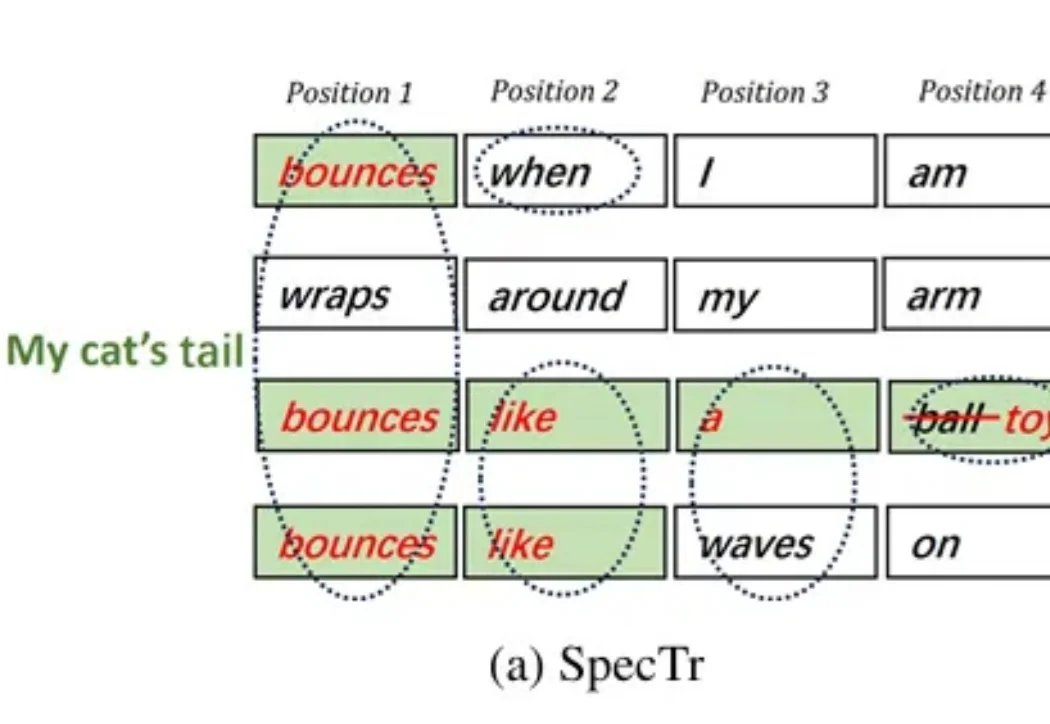
大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
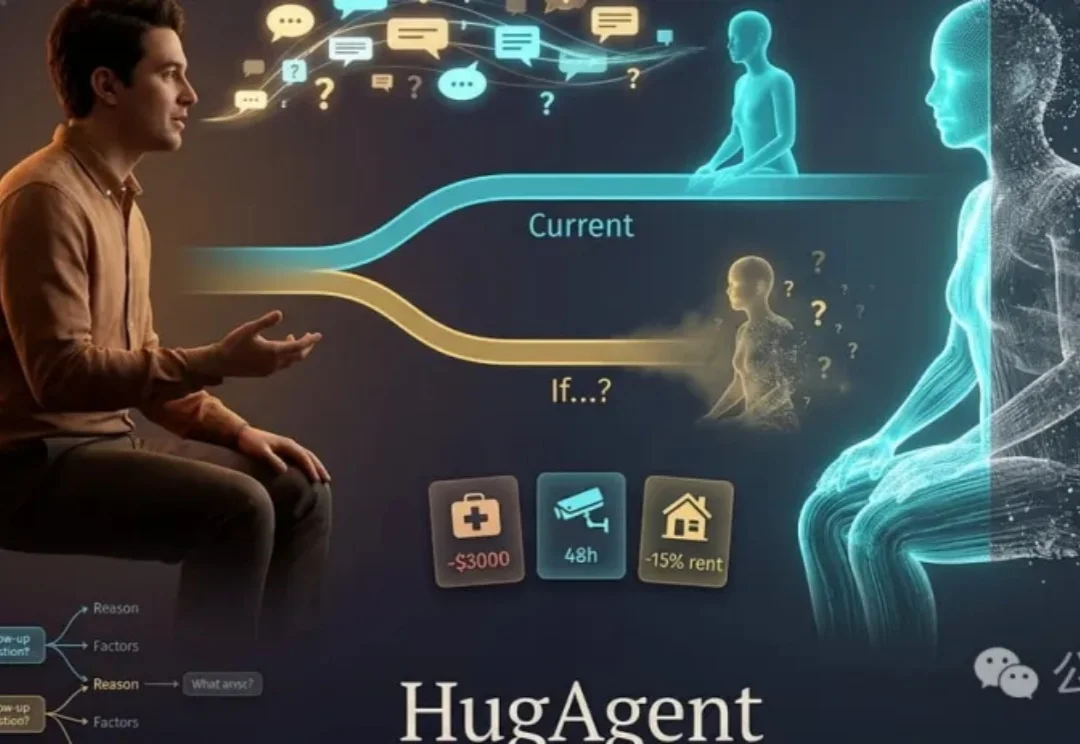
只要和一个人聊得足够久,大模型就能成为他的「数字分身」吗?
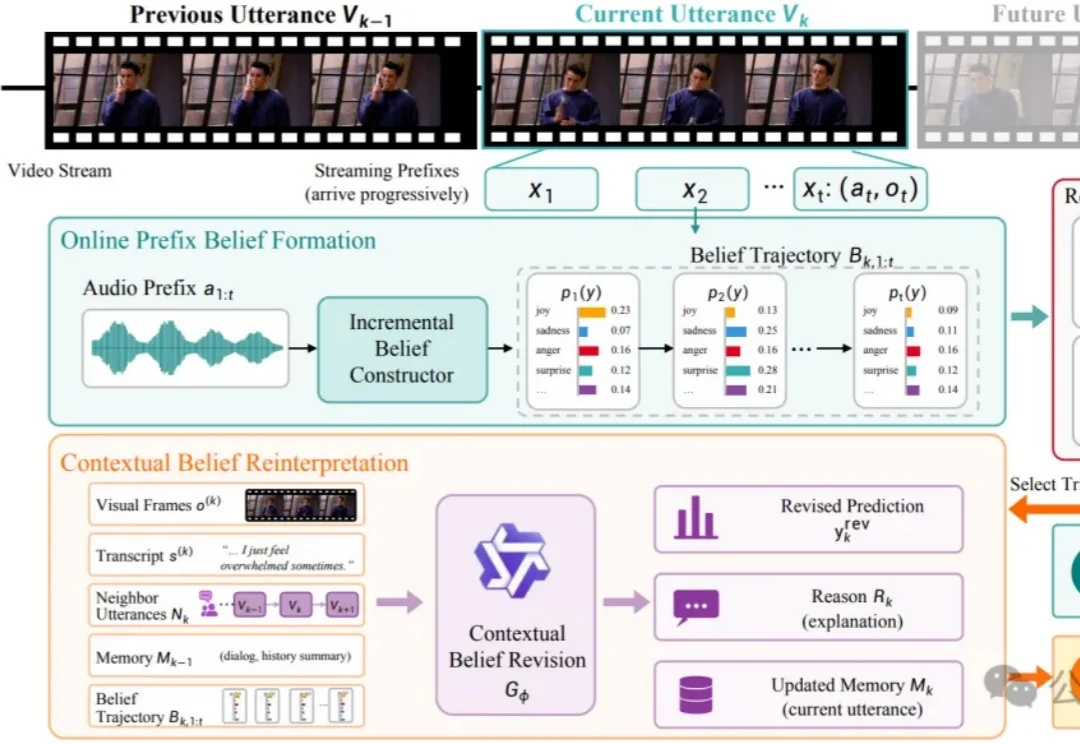
在与用户的实时对话中,AI能否及时感知情绪?模型给出的“高置信度”结论,又是否经得起推敲?
EMNLP 2026录用论文提出Claim-Locked Reporting方法,针对AI审稿等场景中数字正确但方向或结论强度被改写的统计主张失真问题,通过先锁定证据支撑的主张、再由代码固定数字与方向而模型仅负责衔接,在fMRI与临床试验报告上将跨次生成数值复现率分别提升至98.5%和100%,并消除了方向反转错误。