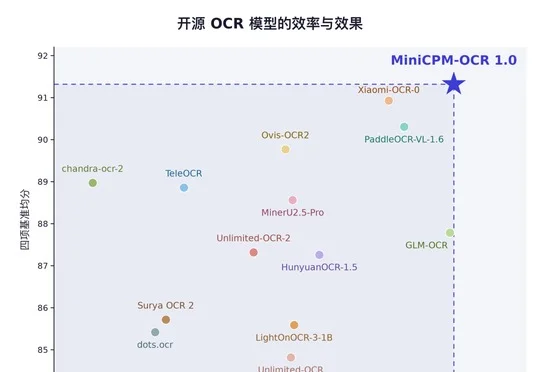
刚刚,面壁智能开源AI横扫全球4项第一!1.3B逆袭大厂,OCR极限实测杀疯了
刚刚,面壁智能开源AI横扫全球4项第一!1.3B逆袭大厂,OCR极限实测杀疯了面壁智能开源MiniCPM-OCR 1.0与MiniCPM-OCR Jev,前者以1.3B参数取得4项SOTA并登顶吞吐,后者独立为OCR结果校准置信度并触发重读或人工复核。
来自主题: AI资讯
9566 点击 2026-10-29 00:41

 搜索
面壁智能开源MiniCPM-OCR 1.0与MiniCPM-OCR Jev,前者以1.3B参数取得4项SOTA并登顶吞吐,后者独立为OCR结果校准置信度并触发重读或人工复核。
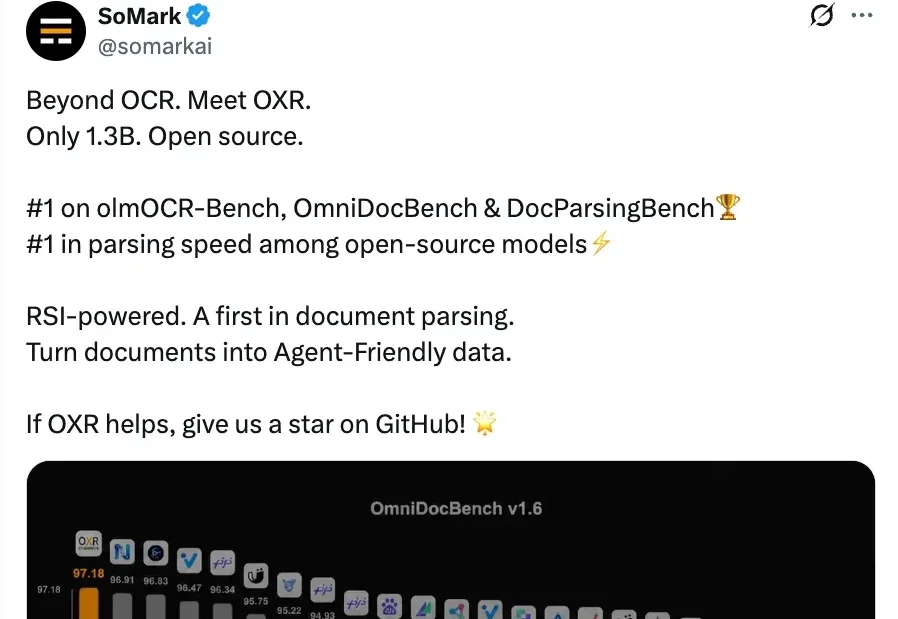
不er,RSI应用在OCR上,效果这么猛??
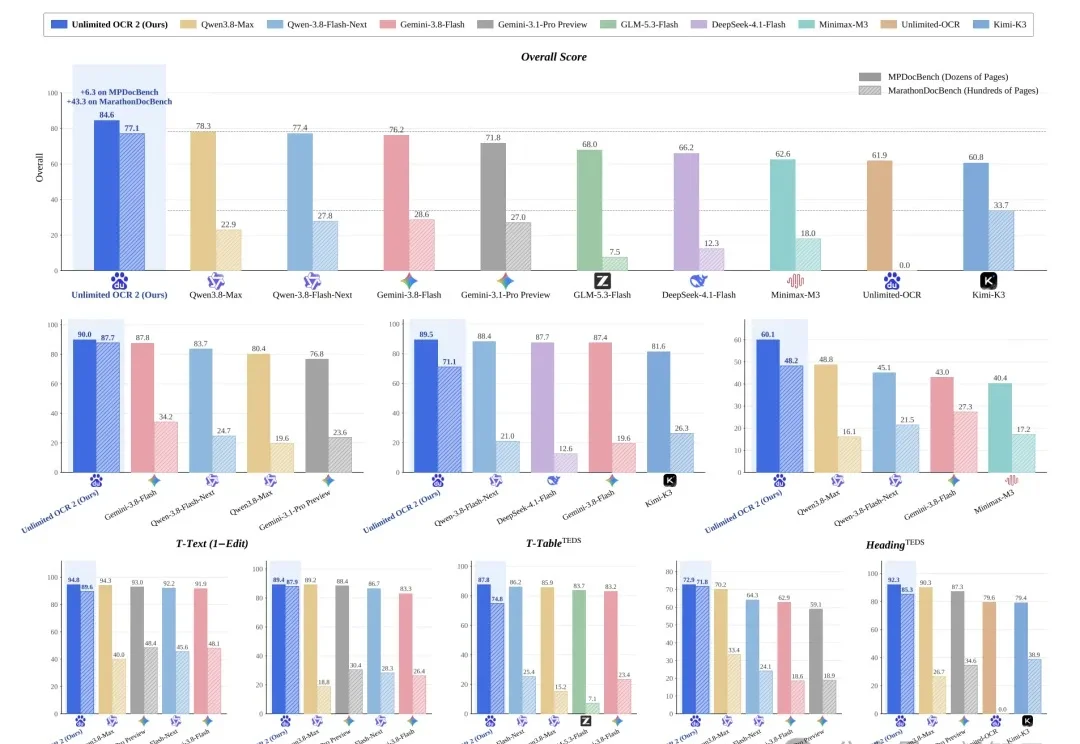
曾获LeCun转发推荐、狂揽1,000万下载的百度开源神作,又杀回来了!
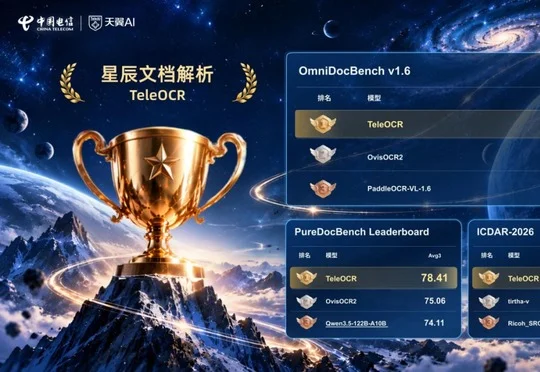
中国电信星辰通用人工智能实验室推出的轻量化文档解析模型TeleOCR(约1.2B参数)凭借形变感知学习、多边形版面分割、CGDP采样及内容—结构解耦等技术创新,在OmniDocBench v1.6、Wild-OmniDocBench、PureDocBench等多个公开榜单取得领先,并在ICDAR 2026 Sci-ImageMiner挑战赛中夺冠,目前已开源。
Jina AI 发布端到端文档解析模型 jina-ocr-v1,以 3.4B 总参数/570M 激活参数在 OmniDocBench v1.6 与 olmOCR-Bench 上刷新同级别最佳成绩,并凭借 FastMTP 推测解码与分级密集奖励在低成本 GPU 上实现无损近倍速生成,单页仅输出 1085 个 token 以 2.57 页/秒吞吐领跑 14 款主流系统。
前DeepSeek核心研究员魏浩然近日带队加入百度基础模型研发部,出任文心大模型多模态算法负责人,负责端到端OCR等方向,其此前主导的Unlimited OCR模型曾在OmniDocBench评测中取得全球第一。
最新开源的Unlimited OCR,总参数3B,实际激活仅500M——放在大模型时代几乎是个零头。但就是这个小到离谱的模型,在OmniDocBench v1.5上拿下93.23%的综合分,v1.6更是达到93.92%,直接刷新了端到端SOTA。
大模型再强,也读不懂你公司那一柜子的合同、发票和扫描件。在"纸张世界"和"LLM世界"之间,缺一座桥——而百度开源的 PaddleOCR,可能就是当下最稳的那座。
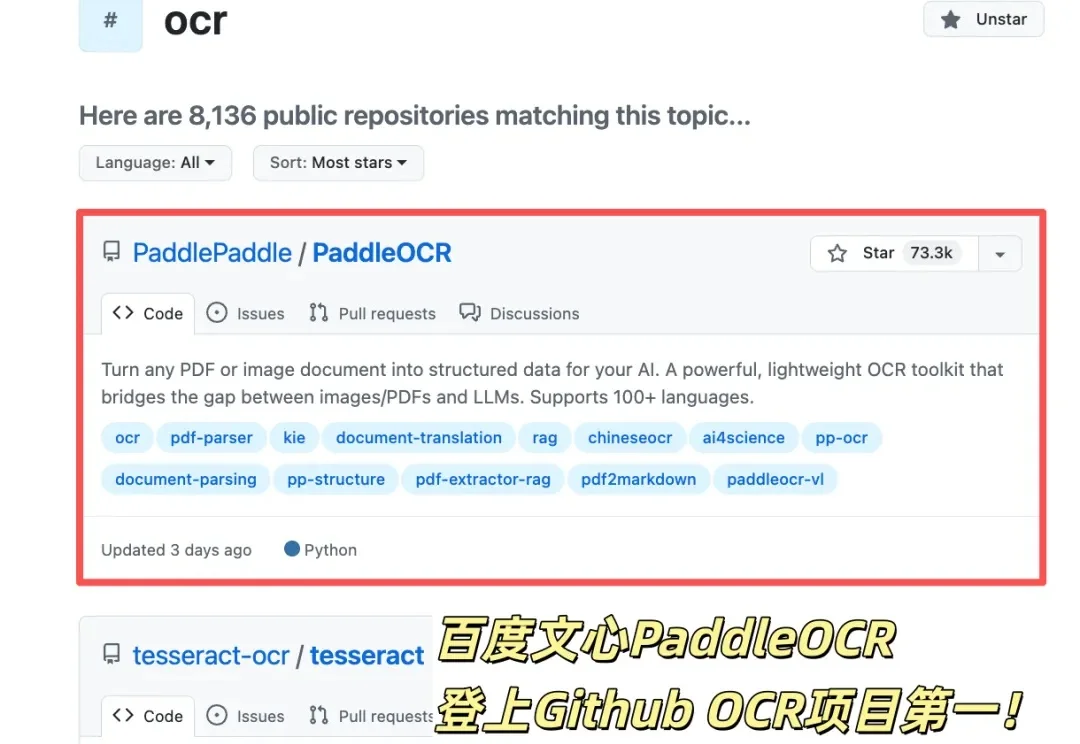
GitHub OCR项目之王刚刚历史性易主。
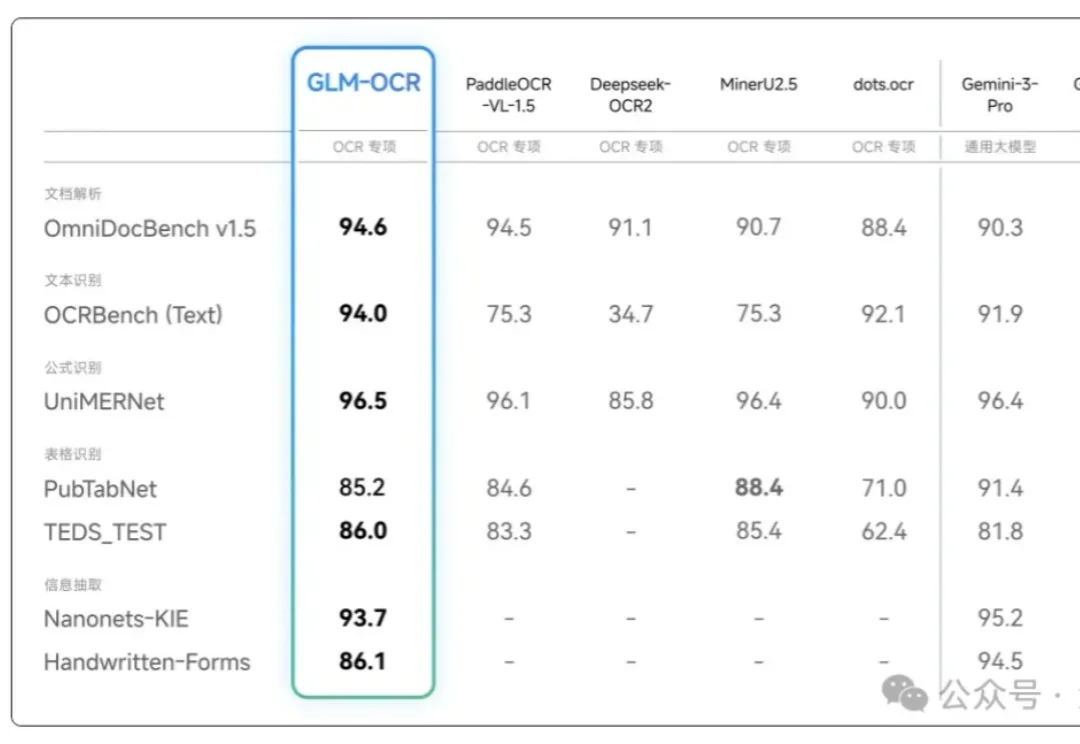
OCR模型究竟能干什么?干得怎么样?