英伟达GPU隐藏算力被开源解锁!不改官方驱动,RTX 4090吞吐翻倍
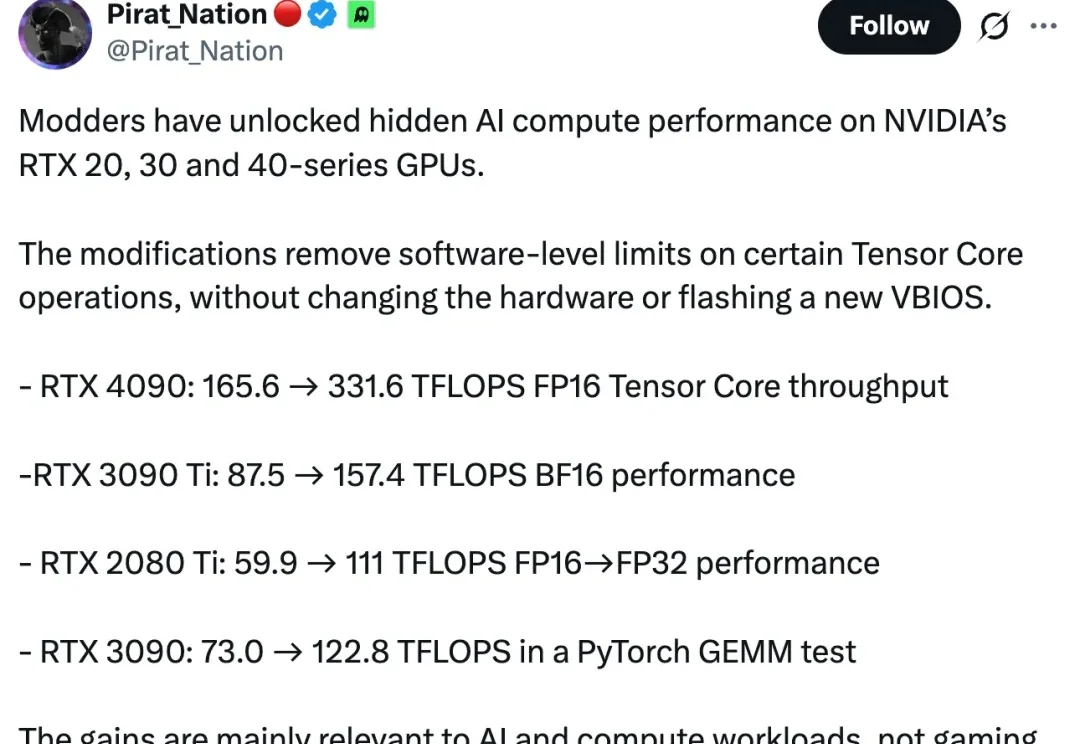
英伟达GPU隐藏算力被开源解锁!不改官方驱动,RTX 4090吞吐翻倍一张 RTX 4090,什么硬件都没换,特定 Tensor Core 运算吞吐率竟然从 165.6 TFLOPS 飙升至 331.6 TFLOPS,直接翻倍!
来自主题: AI资讯
9564 点击 2026-10-27 10:12

 搜索
一张 RTX 4090,什么硬件都没换,特定 Tensor Core 运算吞吐率竟然从 165.6 TFLOPS 飙升至 331.6 TFLOPS,直接翻倍!
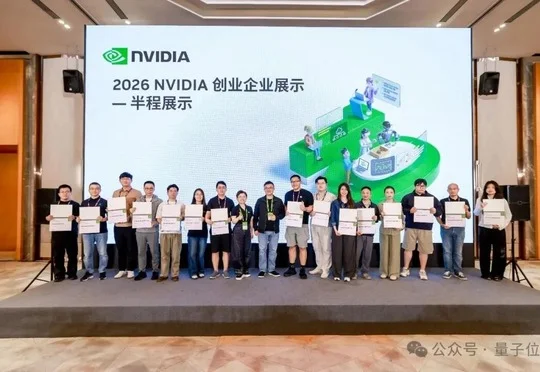
达瓦科技凭借实时世界模型产品Scenes AI拿下NVIDIA半程展示卓越企业奖,其34B模型在单张NVIDIA GeForce RTX消费级显卡上实现720P、25帧实时输出。
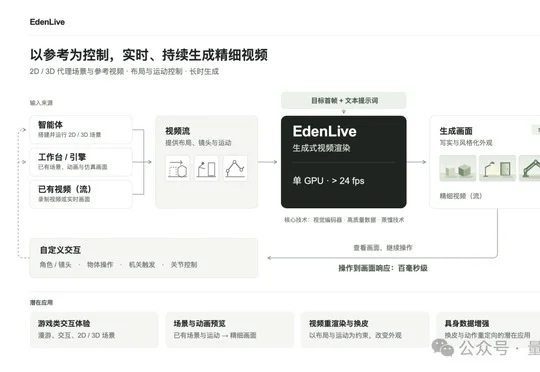
VAST发布并开源实时世界模型EdenLive,支持任意参考输入、不同画风生成和分钟级连续运行,其5B模型在单张Nvidia RTX 5090上以720P生成速度超过24FPS,端到端延迟为百毫秒级。
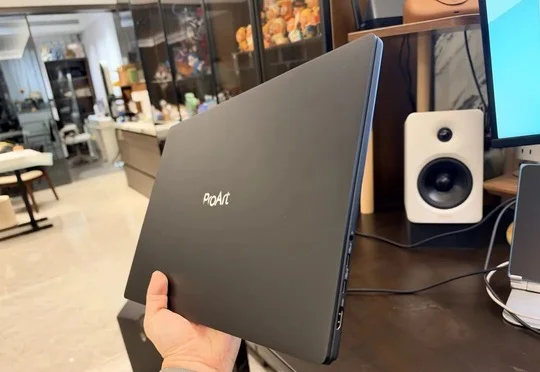
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。
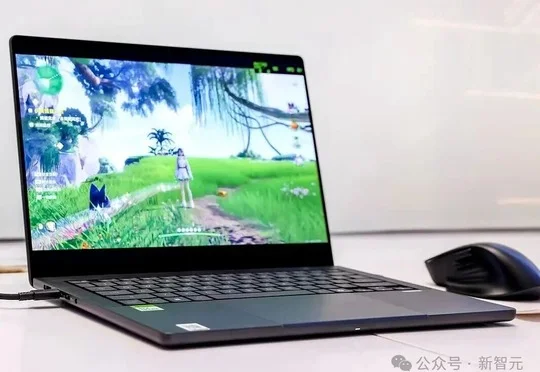
英伟达开放Nemotron 3.5 Bolt模型权重,将740亿参数版本从约148GB压缩至22.1GB以支持笔记本本地Agent任务,搭载RTX Spark的联想、微软等笔记本也于10月16日全球发售。
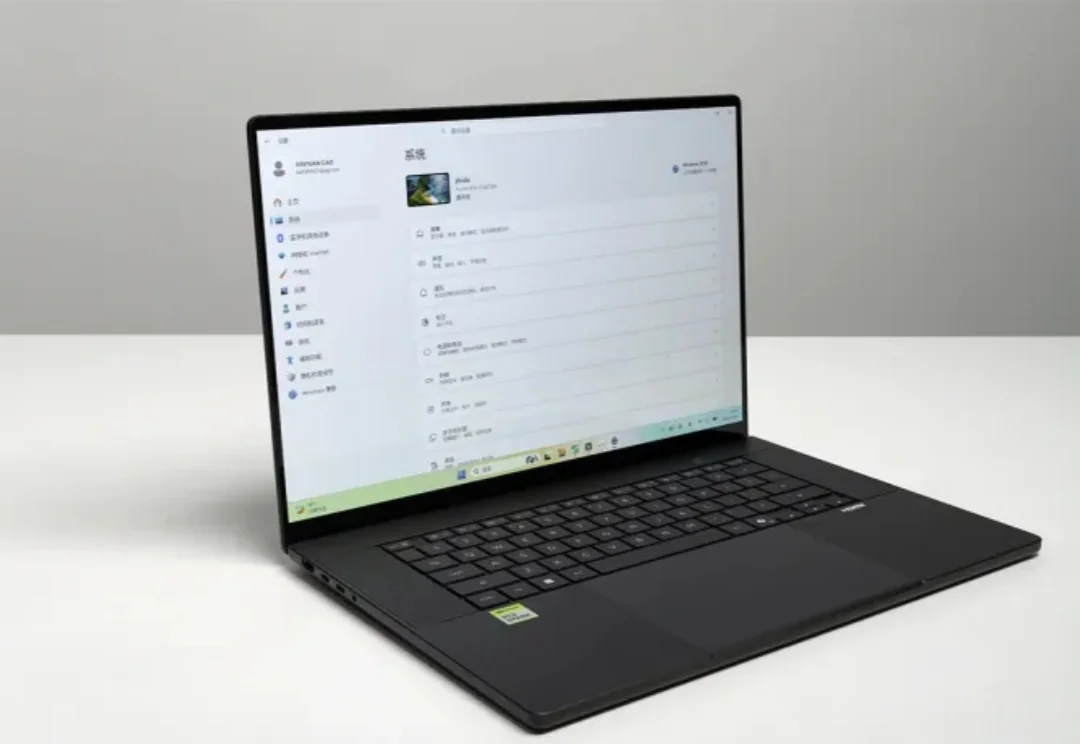
3万块的RTX Spark电脑,能干哪些事?
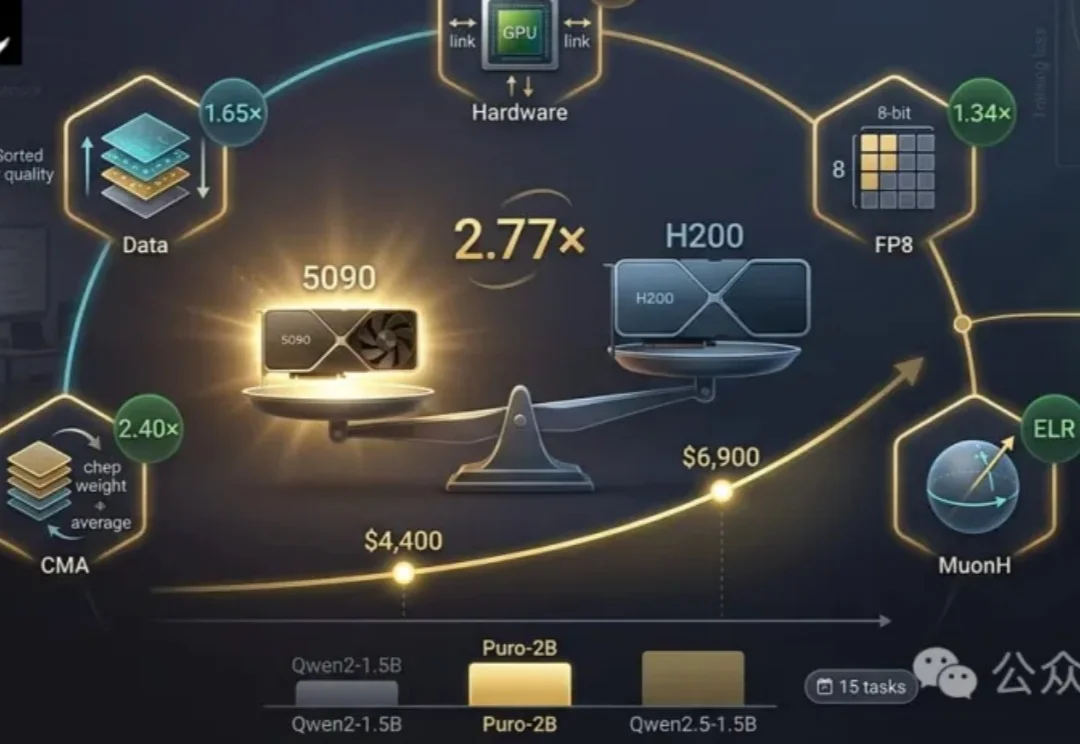
训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?
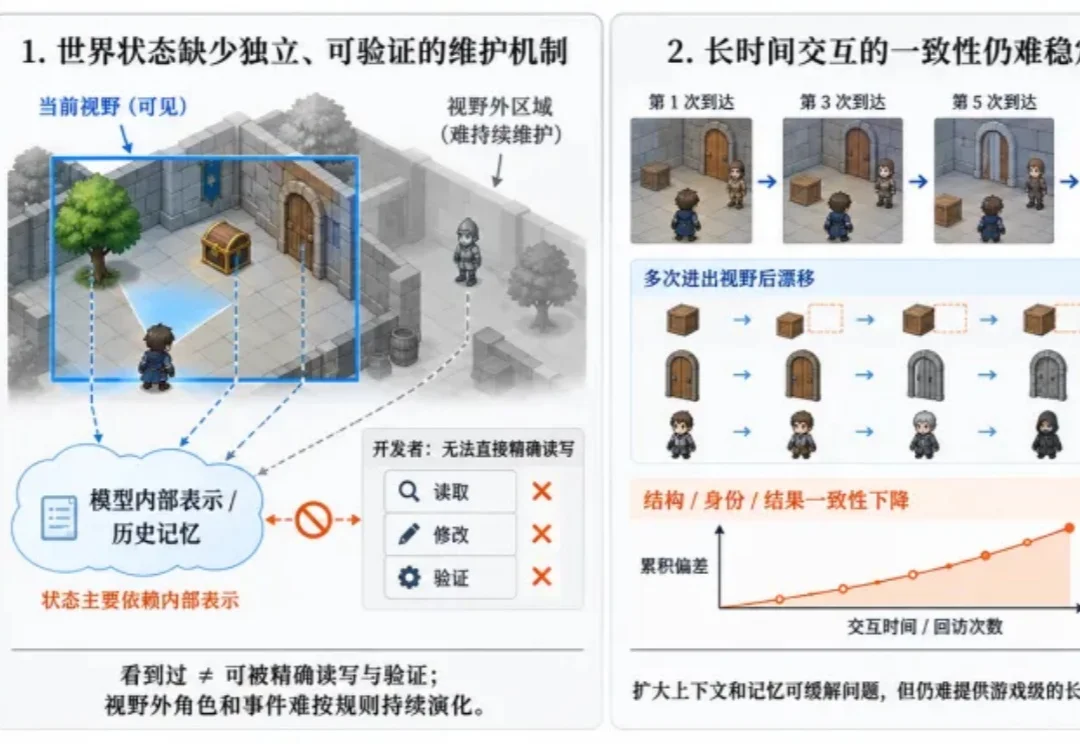
不er,印象中非常吃算力的「游戏世界模型」,居然就这样被塞进一张RTX 5090里了?!
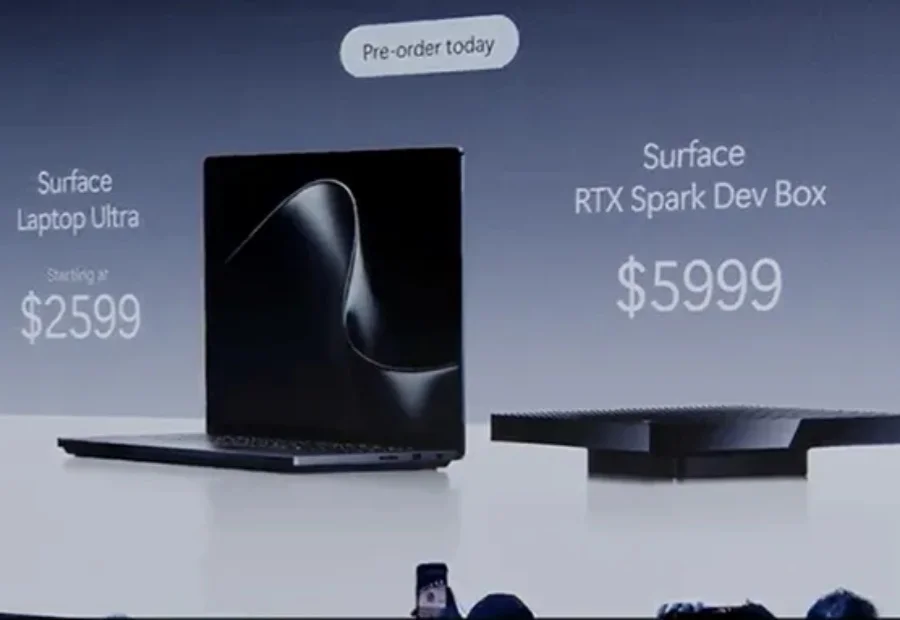
最高20核CPU、6144核GPU、128GB统一内存、1PFLOPS本地AI算力。
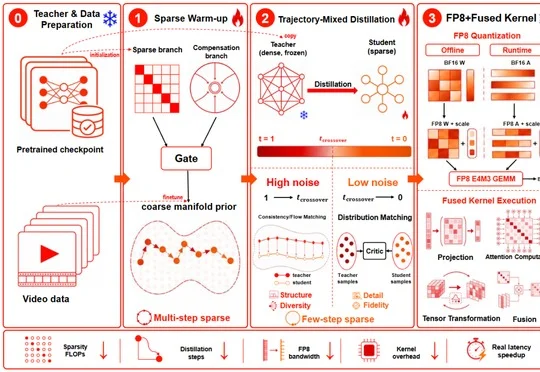
北京大学、清华大学与阿里巴巴等机构联合提出SparkDiffusion视频生成加速系统,通过融合稀疏注意力、少步蒸馏与FP8量化,在单卡RTX 5090上实现最高720倍推理加速,可在18秒内生成5秒720P视频,并已完整开源权重与训练代码。