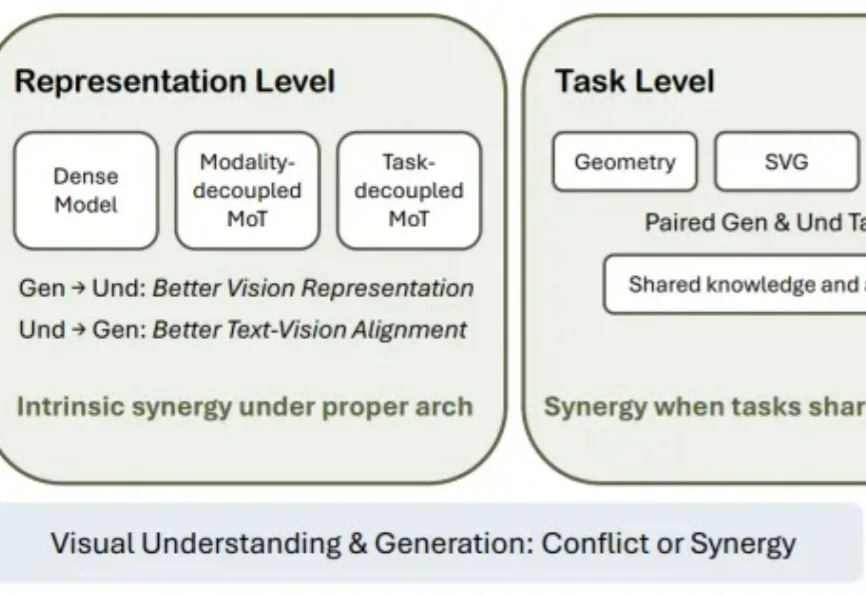
视觉理解和生成究竟能否相互促进?从视觉表征、任务到系统重新审视UMM
视觉理解和生成究竟能否相互促进?从视觉表征、任务到系统重新审视UMM理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
来自主题: AI技术研报
6566 点击 2026-09-14 15:03

 搜索
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
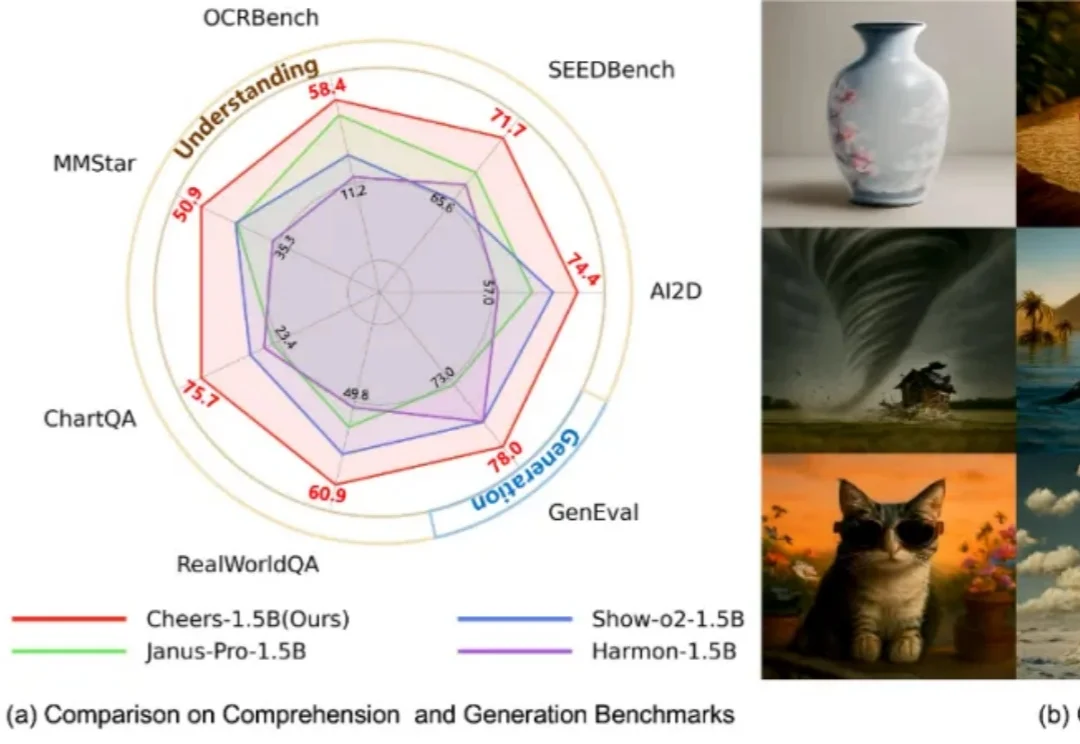
过去几年,多模态模型在理解任务上快速演进,图像问答、OCR、视觉推理、跨模态对话等能力不断提升;与此同时,图像生成模型也在视觉质量、指令遵循和细节表达上持续突破。下一步一个自然的问题是:能否用同一个模型,同时做好理解与生成?这正是统一多模态模型(Unified Multimodal Models, UMMs)正在回答的问题。