
字节的 Seed 悄咪咪整了个会自己进化的模型:一次接入,永远最新!
字节的 Seed 悄咪咪整了个会自己进化的模型:一次接入,永远最新!字节Seed团队推出Seed-Evolving第五版更新,通过统一Model ID实现周级自动迭代,在Coding Agent长程任务完成度和VLM视觉理解能力上均有显著提升,用户一次接入即可享受模型持续进化。
来自主题: AI资讯
8620 点击 2026-09-12 10:03

 搜索
字节Seed团队推出Seed-Evolving第五版更新,通过统一Model ID实现周级自动迭代,在Coding Agent长程任务完成度和VLM视觉理解能力上均有显著提升,用户一次接入即可享受模型持续进化。
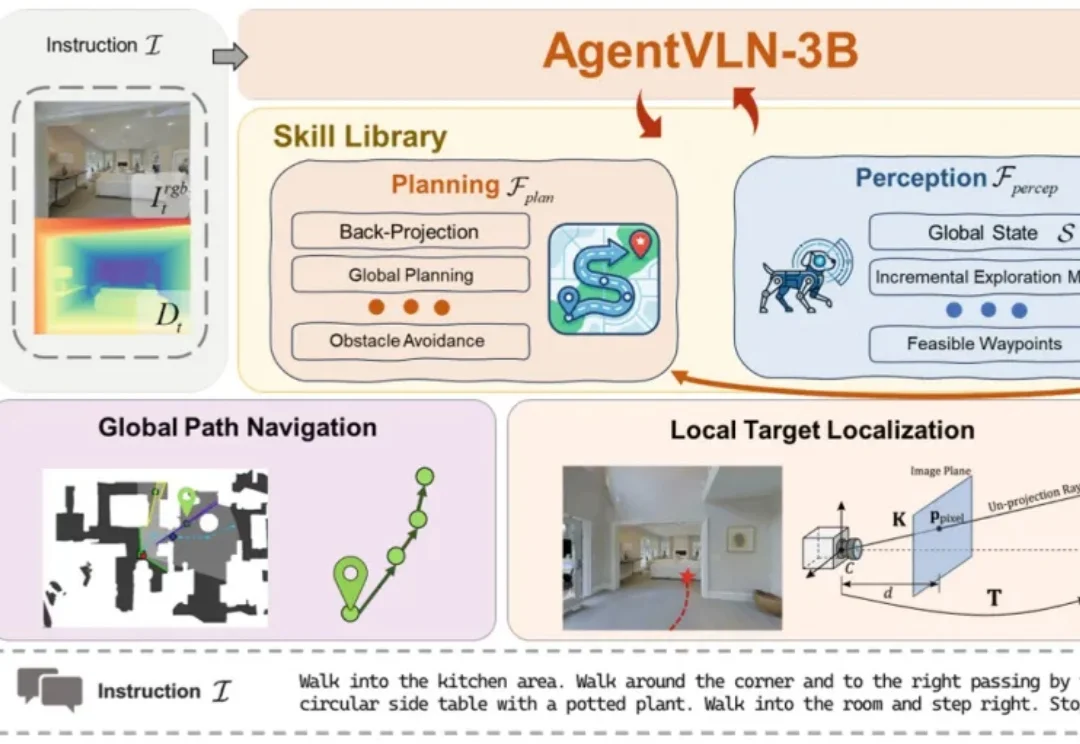
近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
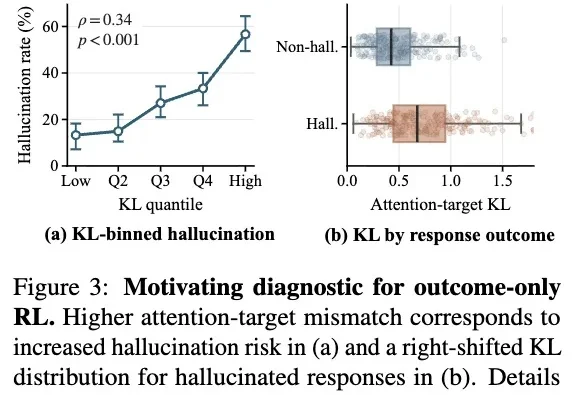
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
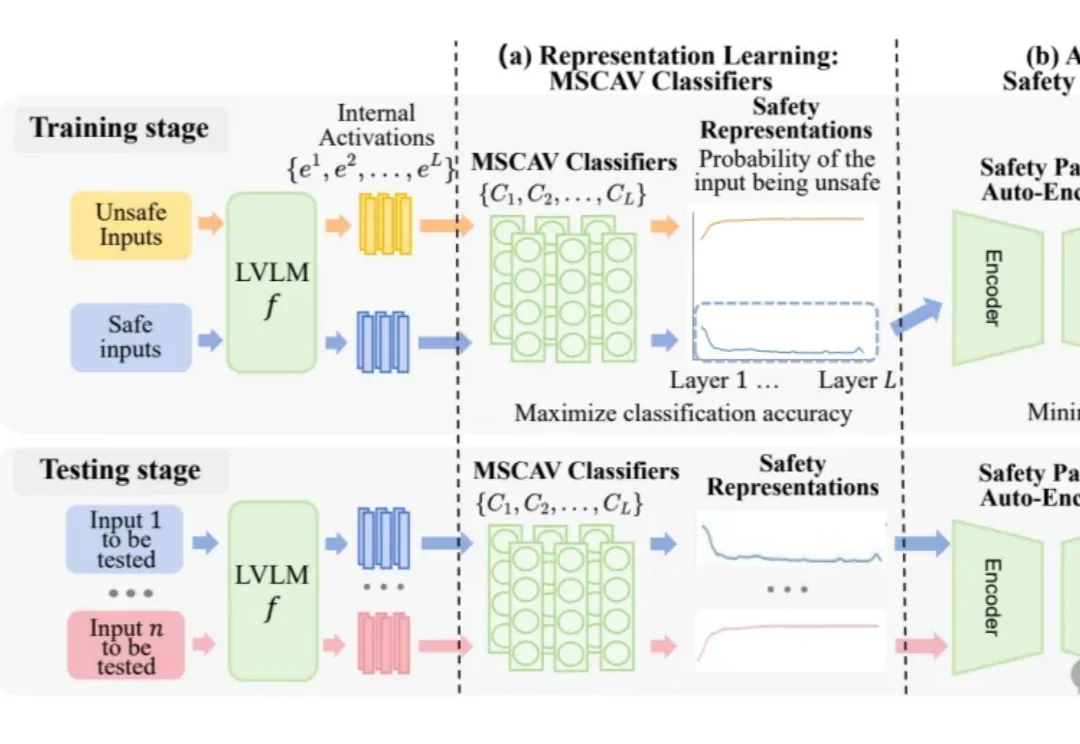
大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。

最近,第三方视觉评测机构Roboflow,把GPT-5.6 「全家桶」拖进自家VLM基准跑了一圈。测试的内容,都是最实在的活儿:找东西、数东西、认字、抽信息。仅在目标检测这项,上一代GPT-5.5只拿到13.8分。这个分数,在视觉模型圈里基本等于交白卷。

Gemini 领跑,GPT表现平平,国立清华、英伟达提出双奖励孪生网络,告别算力焦虑。

独家获悉,具身智能公司LatentVerse已完成数亿元人民币种子轮融资,第一轮投资方包括高瓴创投、清流资本、智元、星动纪元及英诺天使等基金。LatentVerse选择的是第三条路线:不做VLA也不做如今大热的WAM,而是把VLM和世界模型统一在同一个架构里。
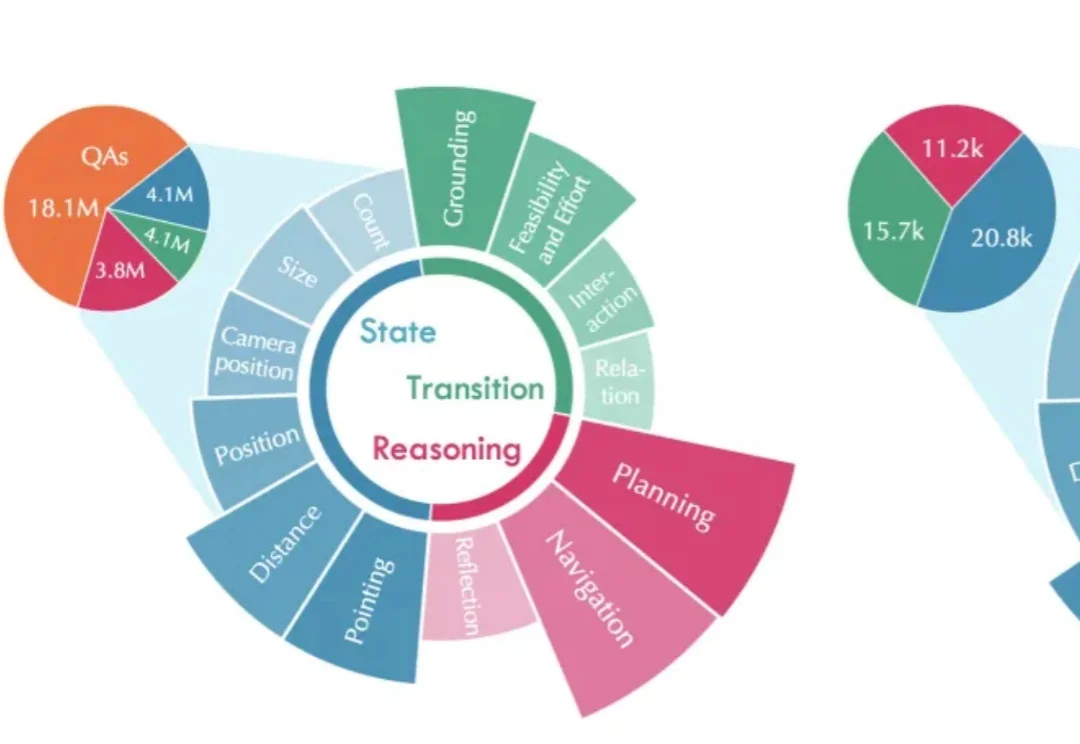
7 月 15 日,腾讯 Robotics X 实验室以及福田实验室联合腾讯混元推出两款具身智能基座模型 —— 具身 VLM 基座模型 Hy-Embodied-VLM-1.0 以及 具身世界认知基座模型 Hy-Embodied-RxBrain-1.0,不仅让具身大脑能够 “看” 懂现实世界,还学会同时推理和想象。
智东西获悉,OpenAI前研究员田永龙(Yonglong Tian)已确认于近期加入腾讯大语言模型部,后续将参与VLM(视觉语言模型)相关研发。在OpenAI期间,田永龙曾参与GPT-5的研发工作。加入OpenAI之前,他在Google Research和DeepMind长期从事视觉表征学习和对比学习等方向研究,对后续视觉模型以及多模态表征学习的发展产生了广泛影响。
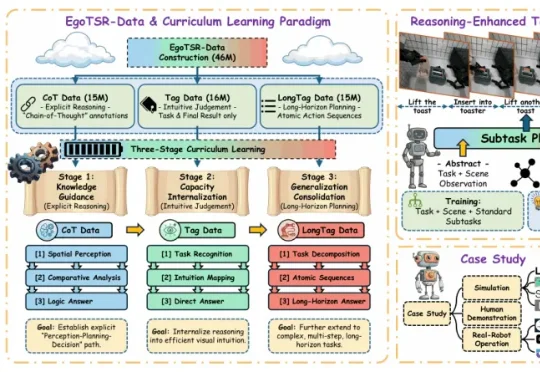
浙江大学等五所高校的研究团队提出 EgoTSR。研究从第一人称机器人视角出发,希望让 VLM 学会判断任务状态,并把这种能力进一步扩展到长程规划。团队构建了包含 4600 万条样本的 EgoTSR-Data,并设计了三阶段课程学习流程。