vLLM-Omni 上的 MiniMax H3:从系统级优化到基于 FastVideo FastH3 的实时服务
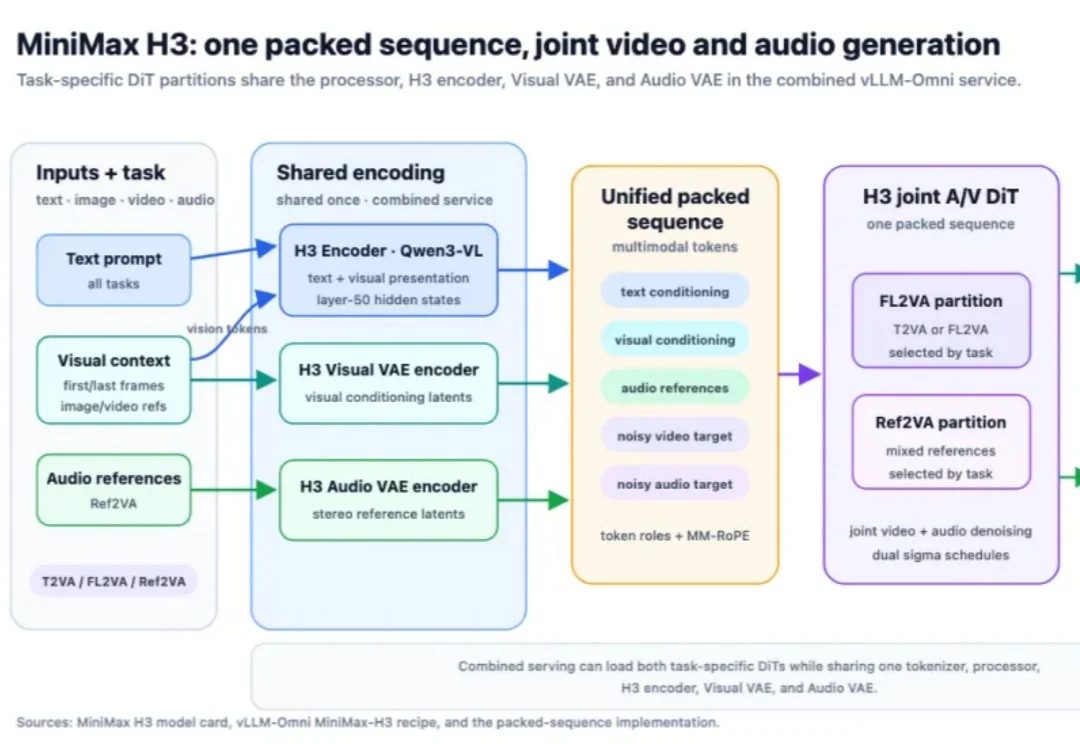
vLLM-Omni 上的 MiniMax H3:从系统级优化到基于 FastVideo FastH3 的实时服务MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
搜索
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
最近,AI短剧的风刮遍了所有平台。
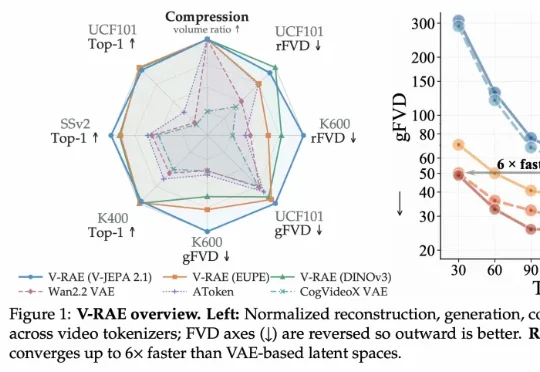
近日,新加坡国立大学 Minghui Guo 与牛津大学 Shengqiong Wu、Hao Fei 在论文《V-RAE: Rethinking Video Latent Spaces for Generation》中提出视频表征自编码器 V-RAE。该方法以冻结的视觉基础模型为编码器,通过轻量级时间池化压缩视频特征,并将具有丰富语义和时间连续性的表征直接用于视频重建、生成与未来预测。
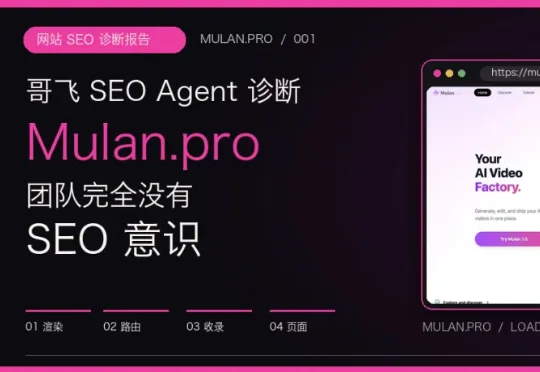
哥飞 SEO Agent 还在继续迭代。Mulan 是一个 AI 视频工作流产品。它把视频生成、编辑和批量生产放在同一条工作流里,首页给自己的定位是 Your AI Video Factory。
新智元报道 这个 8 月,AI 视频赛道的军备竞赛又升级了。 字节跳动发布 Seedance 2.5,把单次视频生成时长从 15 秒翻倍到 30 秒。同一天 MiniMax H3 开源,价格只要闭源旗
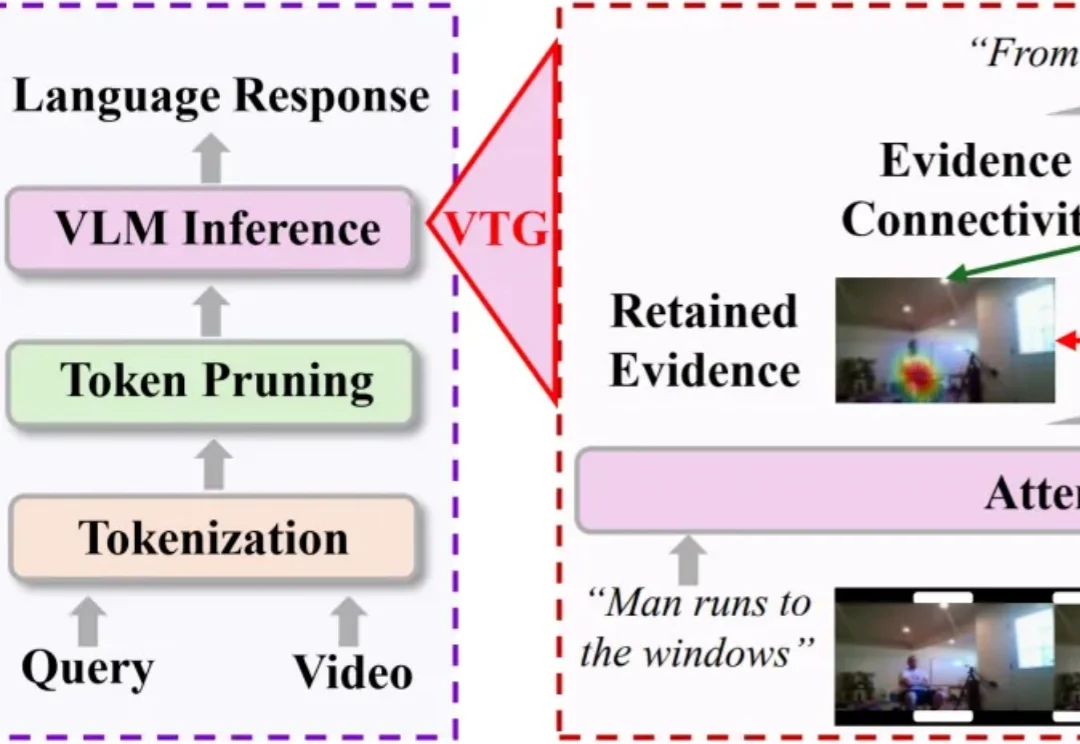
长视频理解,正在成为多模态大模型的重要能力。
Z Potentials 独家获悉,新加坡国立大学博士,牛津大学博士后研究员林庆泓(Kevin)近期以首席研究员(Principal Researcher)身份加入世界模型公司 Video Rebirth,负责多模态智能体与世界模型相关研究。
2026 年,世界模型已成为人工智能领域最受关注的方向之一。从空间智能到表征预测,从可交互环境到具身智能,越来越多研究与产业团队将下一阶段目标指向「理解世界」。行业竞争的焦点,也已从「是否进入世界模型」,转向「以何种技术路径实现世界模型」。
视频是描述物理世界的重要数据形态,更是人类与物理世界交互的重要载体,视频理解大模型是让 AI 从数字世界走向物理世界最基础、最原生的组成部分。
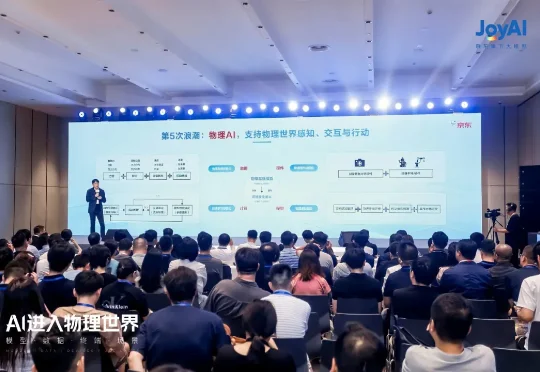
在今天上午结束的「AI 进入物理世界」京东分论坛上,其对外集中展示了这套布局。除了首次集体亮相的 JoyAI 全系列大模型矩阵,具身数据采集体系、JoyInside 智能硬件和京东云 AI 基础设施也一同亮相,它们连同全链路业务场景组成了京东的物理 AI 闭环。