AI资讯新闻榜单内容搜索-benchmark

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: benchmark
GPT-6登顶第一!AlphaFold之后最大震撼,成抗体预测最强AI

GPT-6登顶第一!AlphaFold之后最大震撼,成抗体预测最强AI

GPT-6登顶第一!AlphaFold之后最大震撼,成抗体预测最强AI

OpenAI发布的GPT-6 Astra在Insilico Medicine构建的DDD Benchmark抗体可开发性预测测试中以37.98分登顶第一,在不依赖外部专用工具的情况下击败所有前沿模型,标志着通用大模型正在突破抗体成药性预测这一生物医药研发的"死亡之谷",成为AlphaFold之后最具震撼性的科学范式转移。

来自主题: AI资讯
8753 点击    2026-09-11 16:06
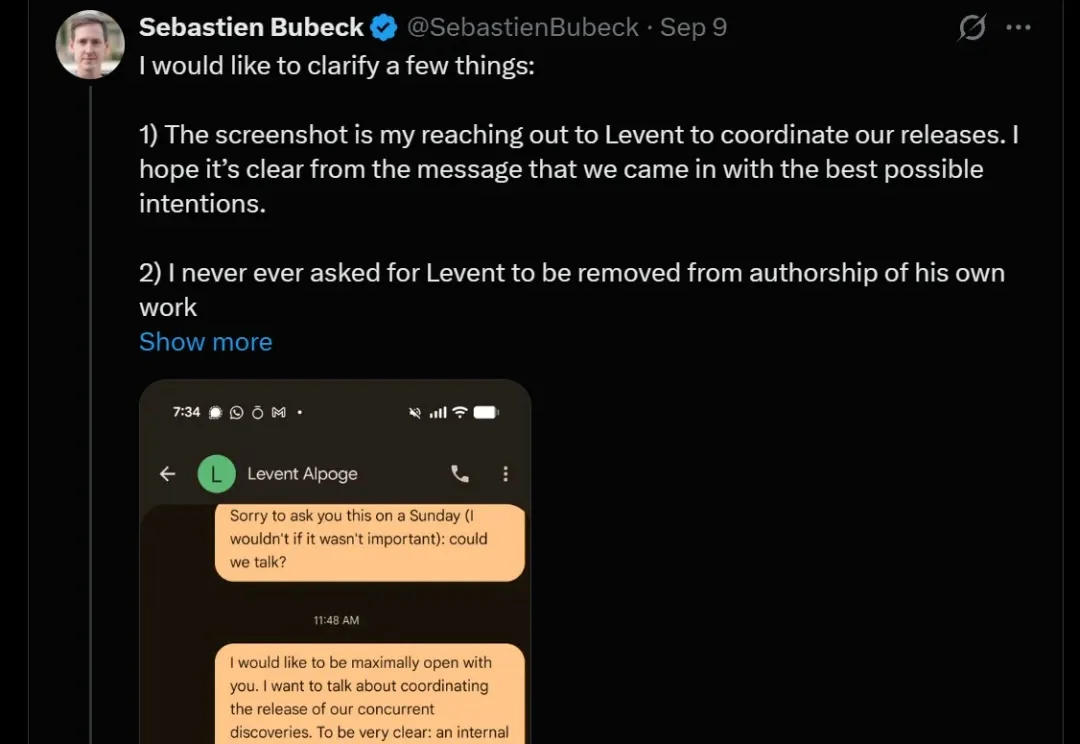
OpenAI这是拿千禧年难题当Benchmark刷啊。。。

OpenAI这是拿千禧年难题当Benchmark刷啊。。。

OpenAI这是拿千禧年难题当Benchmark刷啊。。。

《纽约时报》最新追访,补出了这场冲突中此前没有披露的细节。

来自主题: AI资讯
8232 点击    2026-09-11 10:14
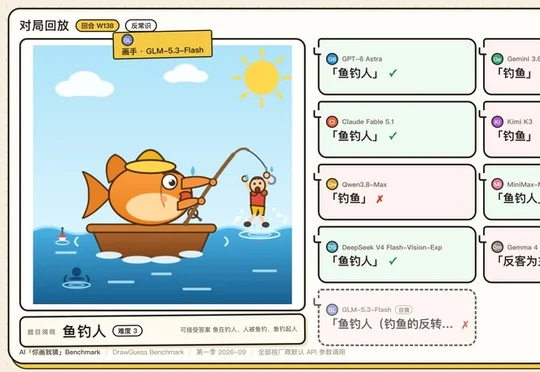
Eval丨 我们做了个“你画我猜 Benchmark” :1350 张图后,GPT-6 险胜

Eval丨 我们做了个“你画我猜 Benchmark” :1350 张图后,GPT-6 险胜

Eval丨 我们做了个“你画我猜 Benchmark” :1350 张图后,GPT-6 险胜

我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。

来自主题: AI技术研报
9347 点击    2026-09-06 11:05
字节系之外,RunningHub突围:顶级AI模型争夺“首发阵地”

字节系之外,RunningHub突围:顶级AI模型争夺“首发阵地”

字节系之外,RunningHub突围:顶级AI模型争夺“首发阵地”

模型的发布流程,早已在密集迭代中演变为精准的工业流水线:技术报告开路,Benchmark榜单刷屏,紧接着开放API,最后以开源权重收尾。

来自主题: AI资讯
10436 点击    2026-08-25 11:41
开启Benchmark的Harness时代:15家学术机构联合发布HarnessEval

开启Benchmark的Harness时代:15家学术机构联合发布HarnessEval

开启Benchmark的Harness时代:15家学术机构联合发布HarnessEval

8 月 13 日,DeepSeek 开源 Agent Harness dsh,将 “Harness” 这个原本更偏工程语境的概念,推到了整个 AI 行业讨论的中心。

来自主题: AI产品测评
7551 点击    2026-08-19 14:37
速来网吧线下真实所有大模型

速来网吧线下真实所有大模型

速来网吧线下真实所有大模型

最近,葬AI和我们的朋友钟经纬、正阳一起,推出了懂模帝这个产品,现在任何人都可以登陆 fuckai.md 去看各种各样的benchmark。

来自主题: AI资讯
8517 点击    2026-08-17 10:53
深度|17个月估值11亿美元, Starcloud的豪赌:把AI数据中心搬到太空

深度|17个月估值11亿美元, Starcloud的豪赌:把AI数据中心搬到太空

深度|17个月估值11亿美元, Starcloud的豪赌:把AI数据中心搬到太空

2026 年 3 月,轨道数据中心公司 Starcloud 宣布完成 1.7 亿美元 A 轮融资,由 Benchmark 与 EQT Ventures 领投,估值达到 11 亿美元,累计融资额达到 2 亿美元。

来自主题: AI资讯
10076 点击    2026-08-12 01:26
让生成式模型「画」出空间智能,而非强迫LLM输出「坐标」! 浙大提出Agentic空间认知评估框架

让生成式模型「画」出空间智能,而非强迫LLM输出「坐标」! 浙大提出Agentic空间认知评估框架

让生成式模型「画」出空间智能,而非强迫LLM输出「坐标」! 浙大提出Agentic空间认知评估框架

近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。

来自主题: AI技术研报
8891 点击    2026-08-08 13:34
深度|对话OpenAI推理教父:为什么说现有的Benchmark让我们严重低估了AI能力?

深度|对话OpenAI推理教父:为什么说现有的Benchmark让我们严重低估了AI能力?

深度|对话OpenAI推理教父:为什么说现有的Benchmark让我们严重低估了AI能力?

本期播客,No Priors 请来了一位在 AI 推理领域被业内称为「教父级」人物的研究者Noam Brown。他是 OpenAI 的研究科学家,也是推动「test-time compute scaling」成为行业主流方向的关键人物之一。从扑克 AI 到前沿大模型的评估方法论,Brown 的研究轨迹几乎与整个行业对「推理」认知的升级同步。

来自主题: AI资讯
5731 点击    2026-08-05 11:04
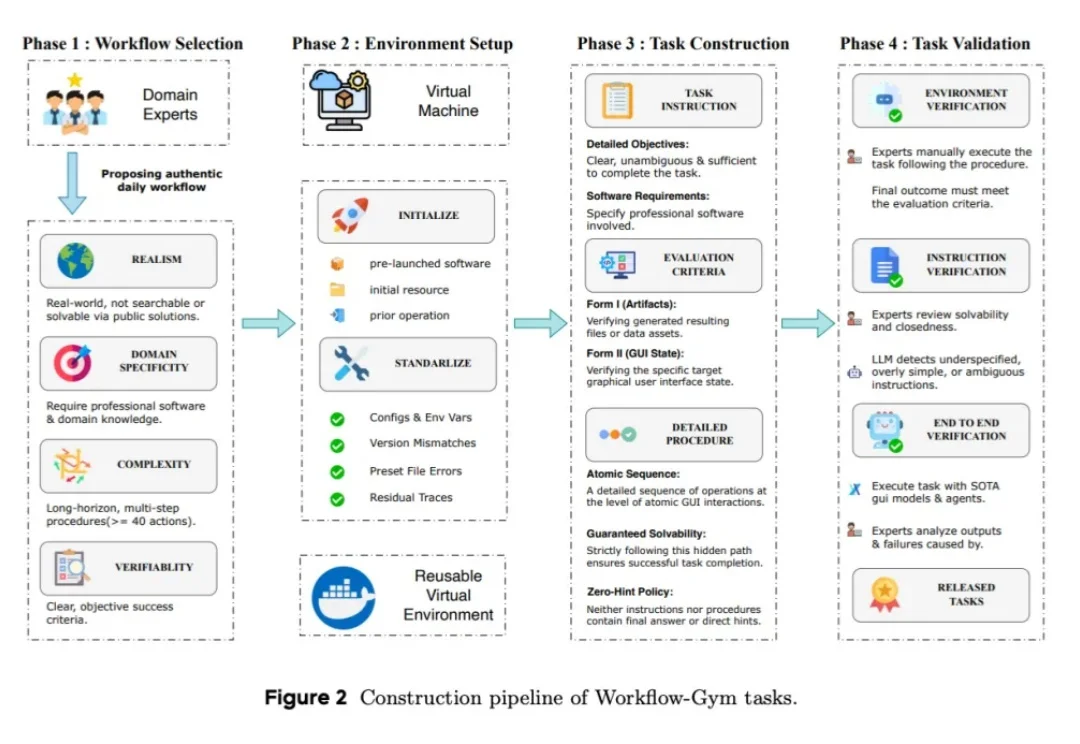
Workflow Gym:告别仿真测试,抹平Agent落地鸿沟

Workflow Gym:告别仿真测试,抹平Agent落地鸿沟

Workflow Gym:告别仿真测试,抹平Agent落地鸿沟

你可能已经在各种 benchmark 榜单上看过 GUI Agent 的 "大胜" 了。

来自主题: AI技术研报
7281 点击    2026-07-24 10:45