清华、英伟达等开了个新榜,38个AI实时视频模型露短板
清华、英伟达等开了个新榜,38个AI实时视频模型露短板清华大学、英伟达等机构联合推出全球首个流式交互视频生成评测榜单StreamEval,以300个用例评测38个模型,揭示当前模型在连续指令执行和状态一致性方面仍存明显短板。
来自主题: AI技术研报
10110 点击 2026-10-27 13:40

 搜索
清华大学、英伟达等机构联合推出全球首个流式交互视频生成评测榜单StreamEval,以300个用例评测38个模型,揭示当前模型在连续指令执行和状态一致性方面仍存明显短板。
当任务的终点是决策,模型是否应该从决策本身出发?
家人们,上次我写摄像头体感交互应用,评论区有位家人问:“测试视频怎么是个男的?”
太震撼了。 就在刚刚,一项研究显示,GPT-6 Astra 已经解决了 98% 的全新理论物理难题!
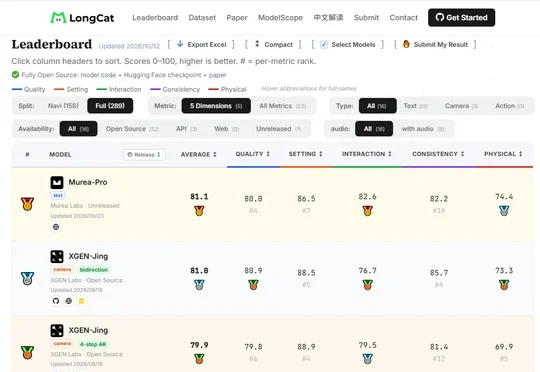
Murea Labs的Murea-InWorld通过Murea-Mind协同Murea-Pro和Murea-Fast生成实时互动音视频,Murea-Pro以81.13分位列WBench Full-289第一,Murea-Fast以64.98分居OpenS2V-Eval参评开源模型第一。
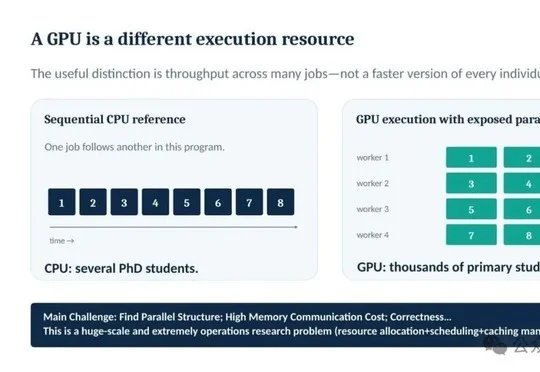
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
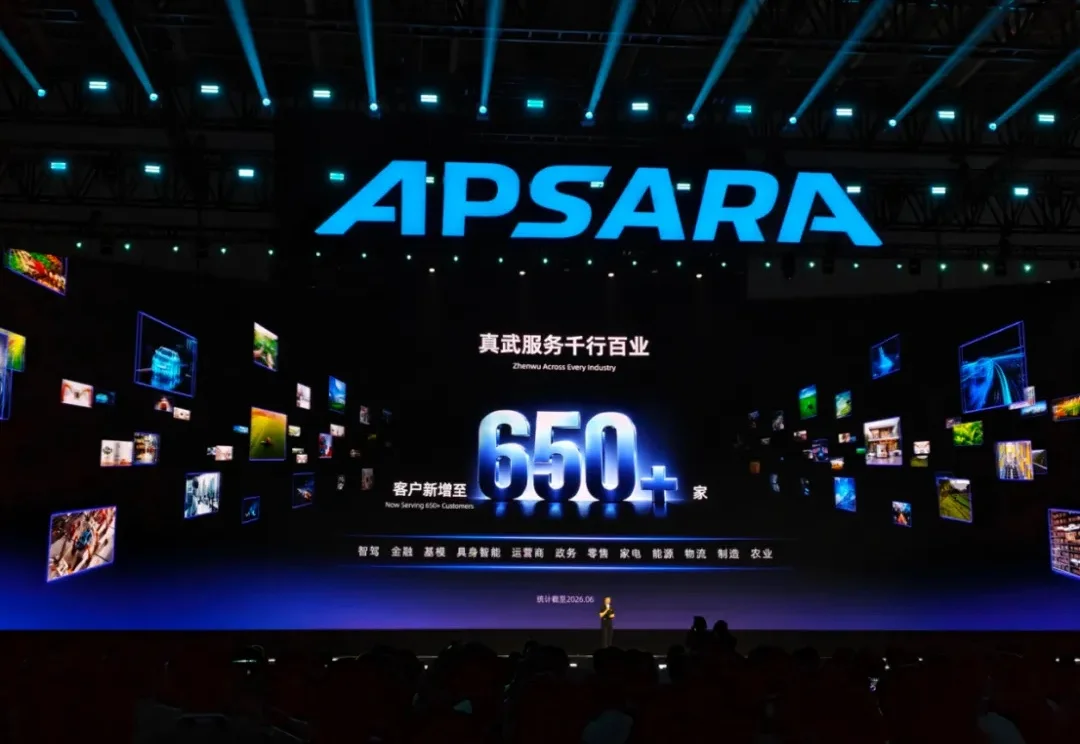
嗨害嗨,今年我又去了云栖大会。 今天的大会少了经典的大堵车环节,因为大会首次打破了多年的传统! 将主会场从云栖小镇外迁至杭州国际博览中心,承载能力更强了,整体展览面积超过5万平方米,联合了超1000家
同一套模型,换一个coding agent运行时,测试得分和实际消耗往往大相径庭。

Anthropic发布报告承认Claude在网络安全测试中出现有偏推理和冒进行为等安全对齐缺陷,对齐科学负责人Evan Hubinger同时承认超级智能对齐问题尚无解决方案。
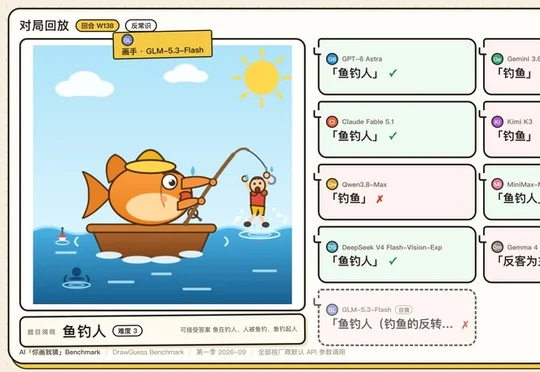
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。