不用反向传播,也能预训练Transformer,Jeff Dean投的这家公司出成果了
不用反向传播,也能预训练Transformer,Jeff Dean投的这家公司出成果了训练大模型,能不能不用反向传播?
来自主题: AI技术研报
6243 点击 2026-10-27 09:19

 搜索
训练大模型,能不能不用反向传播?
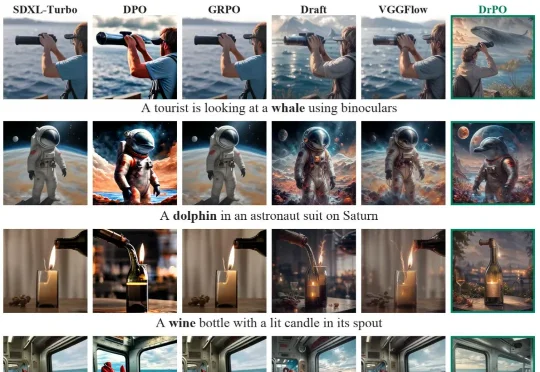
来自西湖大学和香港中文大学(深圳)的团队沿着这一思路提出 Drifting Preference Optimization(DrPO),把漂移场用于单步文生图模型的偏好后训练。在 DrPO 中,奖励只负责对候选图像排序,不参与反向传播。具体而言,针对同一个文本提示词,当前模型生成一组候选图像。高分样本在特征空间中产生吸引,低分样本产生排斥,并结合参考模型约束给出模型的更新方向。
OpenClaw-RL的核心价值在于:它能让您的OpenClaw🦞仅仅通过与你日常对话产生的自然反馈(如你的纠正、补充说明或环境报错),就能在后台实时自动更新权重,变得越来越符合您的个性化偏好,并在实际任务中不再犯同样的错误。
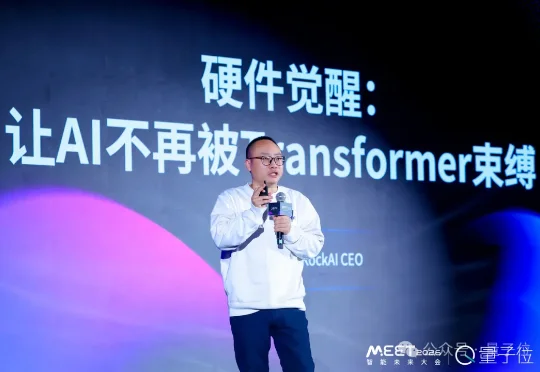
“人工智能要发展到下一个台阶,一定要突破两座大山。第一座大山是Transformer,第二座大山是反向传播算法。”在大模型规模不断拔高、算力与数据卷到极致的当下,RockAI创始人刘凡平提出了一个与主流共识截然不同的判断。
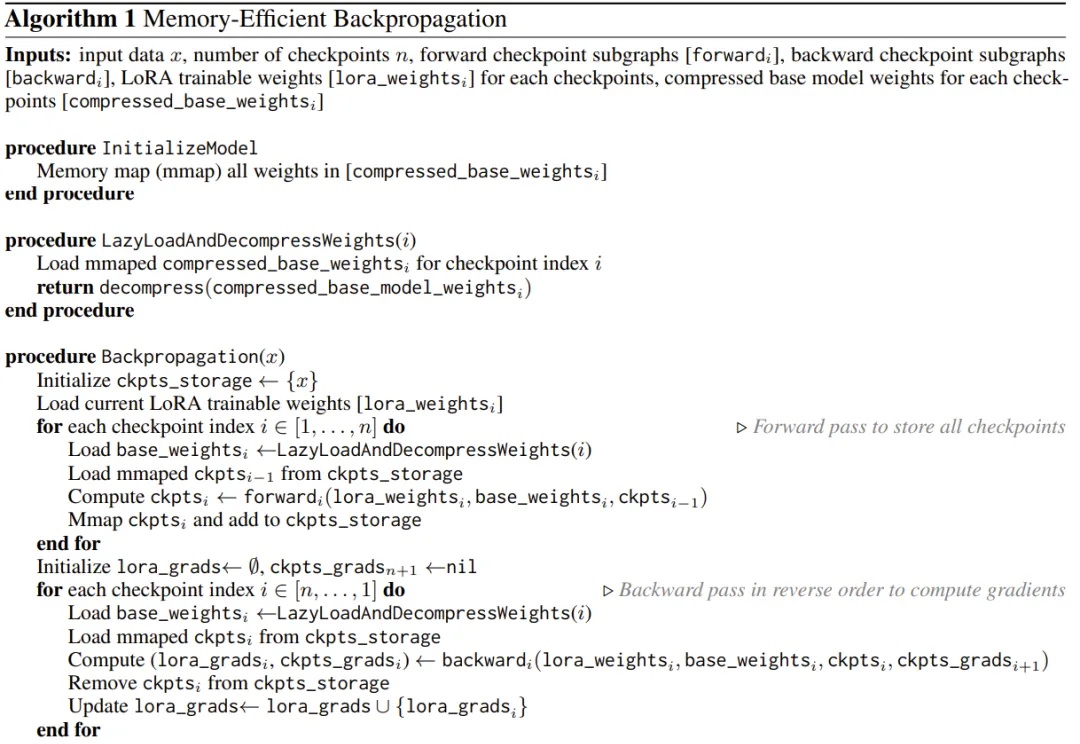
用 iPhone 本地跑大模型已经不是新鲜事了,但能不能在 iPhone 上微调模型呢?
Noprop:没有反向传播或前向传播,也能训练神经网络。
华人学者、斯坦福大学副教授 James Zou 领导的团队提出了 TextGrad ,通过文本自动化“微分”反向传播大语言模型(LLM)文本反馈来优化 AI 系统。只需几行代码,你就可以自动将用于分类数据的“逐步推理”提示转换为一个更复杂的、针对特定应用的提示。
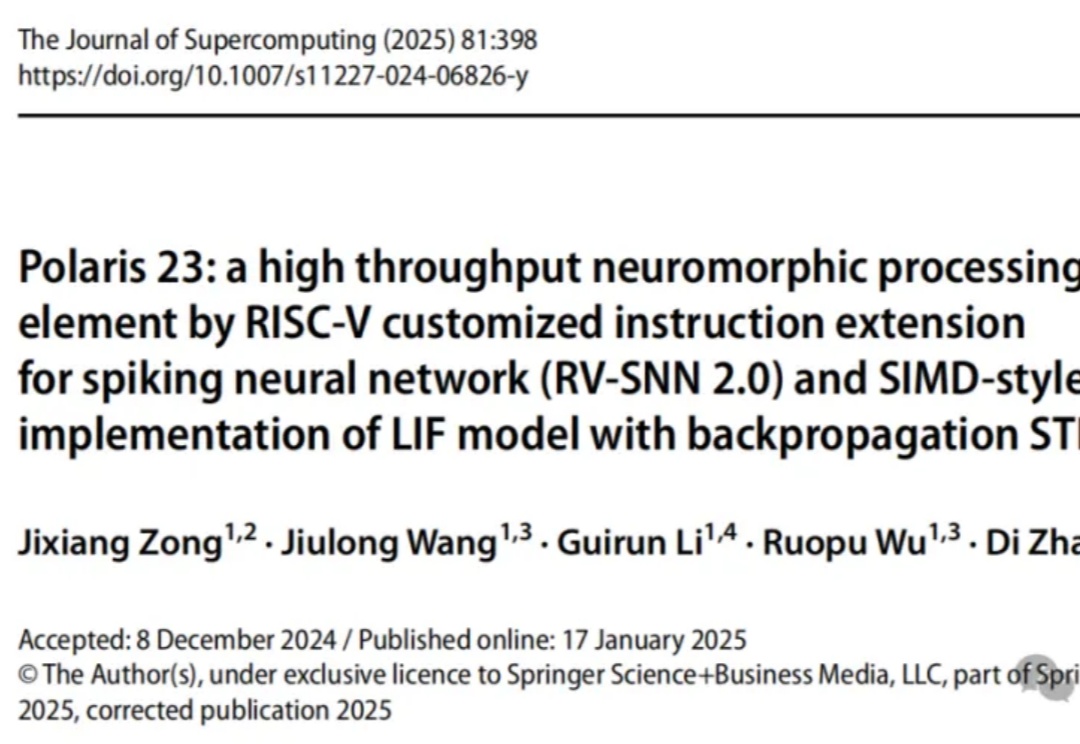
在今年1月《Journal of Supercomputing》上开源的「开源类脑芯片」二代(Polaris 23)完整版本源代码,基于RISC-V架构,支持脉冲神经网络(SNN)和反向传播STDP。该芯片通过并行架构显著提升神经元和突触处理能力,带宽和能效大幅提升,MNIST数据集准确率达91%。
视觉语言模型(如 GPT-4o、DALL-E 3)通常拥有数十亿参数,且模型权重不公开,使得传统的白盒优化方法(如反向传播)难以实施。
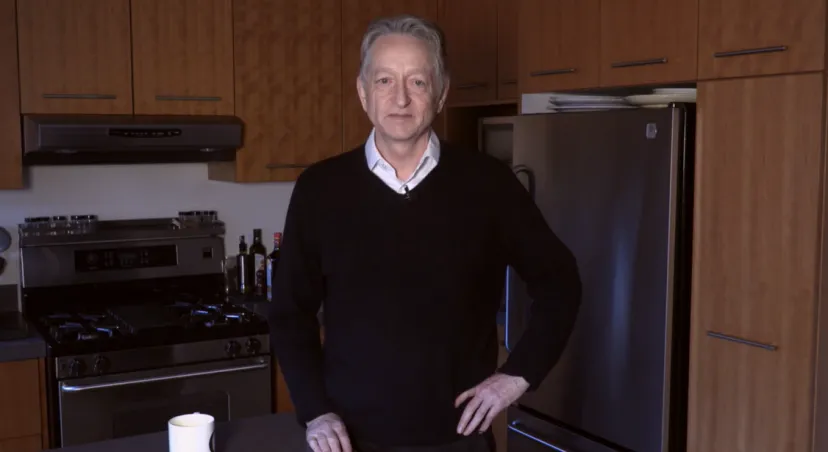
Hinton在人工智能领域的贡献极其卓越,被誉为 “神经网络之父”、“人工智能教父”。他的主要贡献包括:反向传播算法的改进与推广、深度学习模型的创新(深度置信网络、卷积神经网络等多个深度学习网络结构)。Hinton还为AI行业培养了包括OpenAI前首席科学家伊尔亚・苏茨克维(Ilya Sutskever)在内的诸多人才。