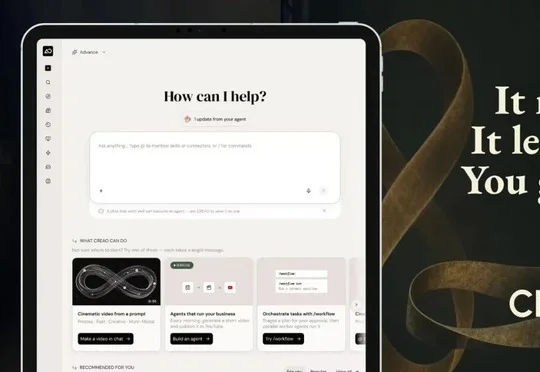
为Agent Harness做自进化,CREAO AI完成千万级美元新融资|智能涌现首发
为Agent Harness做自进化,CREAO AI完成千万级美元新融资|智能涌现首发面向Agent Harness层自进化方向,CREAO AI近日完成千万级美元新融资,资金将用于扩大真实业务工作流与高质量反馈数据规模,加速基于开源模型后训练的垂直模型迭代。
来自主题: AI资讯
9738 点击 2026-08-31 16:50

 搜索
面向Agent Harness层自进化方向,CREAO AI近日完成千万级美元新融资,资金将用于扩大真实业务工作流与高质量反馈数据规模,加速基于开源模型后训练的垂直模型迭代。
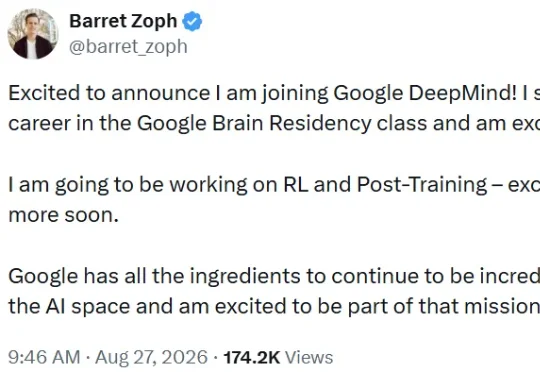
几个小时前,Barret Zoph 在 𝕏 上发了一条推文,他说自己将加入谷歌 DeepMind,而他的 AI 生涯正是从谷歌 Brain 的 Residency 项目起步的,这次算是重返旧地;他将专注于强化学习(RL)与后训练(Post-Training)方向,更多消息稍后公布;他还补了一句,谷歌拥有在 AI 领域持续成功所需要的全部要素,他很高兴能成为这个使命的一部分。
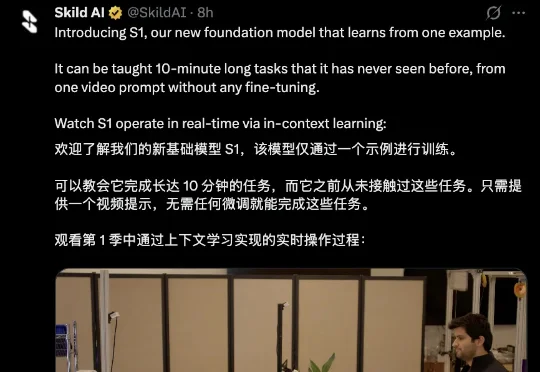
刚刚,北美具身初创Skild AI又发布了全新机器人基础模型S1,直接把机器人上下文学习的任务长度拉到了10分钟往上。这次的S1主打上下文学习(in-context learning,ICL):无需在后训练阶段专门学习新的操作数据,只需看一段人类示范视频,就能“照猫画虎”,直接完成一整套从未见过的复杂操作流程。
近期,字节跳动大模型核心部门Seed完成新一轮组织调整,调整核心集中在Seed Foundation Model(Seed基础模型)板块,新设四个一级部门,重构了预训练数据、强化学习与后训练的组织链路。

随着Agent走向真实工作,后训练和数据正在成为提升智能的关键。

《智能涌现》从相关人士处获悉,混元资深研究员徐灿在近期加入腾讯WeLM团队,从事大模型研发相关工作。多名知情人士透露,在姚顺雨接手腾讯大语言模型研发前,徐灿在混元LLM体系中担任后训练一个方向上的负责人。值得一提的是,这次转岗发生在微信持续强化自研大模型和Agent能力的阶段。
当下,一个逐渐清晰的共识是,具身智能的叙事正由「会不会做一个动作」,转向「能不能在真实世界里稳定完成复杂任务」。尤其是在刚刚过去的 WAIC2026 现场,这一点尤为明显,机器人不再满足于表演式的单动作演示,而是被期待走进产线、仓储和酒店客房,真正「做事」。
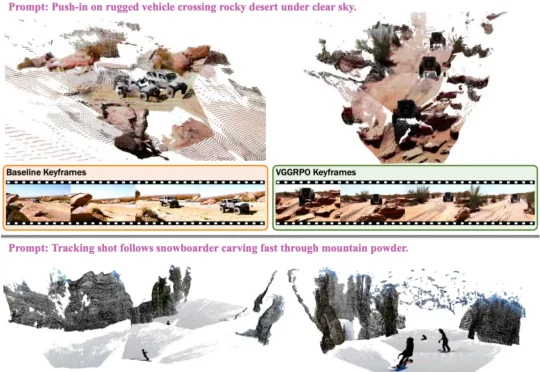
最近,来自 Google、哥本哈根大学、牛津大学等机构的研究者提出了 VGGRPO(Visual Geometry GRPO,收录于 ECCV 2026)。这项工作聚焦于一个核心问题:如何在不牺牲预训练模型泛化能力的前提下,高效地提升视频生成的几何一致性,并使其适用于动态场景。其核心思路是,在隐空间(latent space)中利用 4D 几何奖励,进行几何感知的视频后训练。
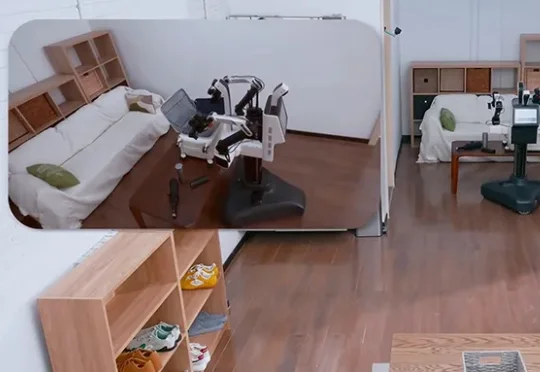
今天,小米刚刚扔出一颗“深水炸弹”——Xiaomi-Robotics-1具身基座模型,试图改变这一局面。Xiaomi-Robotics-1基于10万小时真实世界操作轨迹进行预训练,再用约1.1万小时跨本体数据完成后训练。据悉,这是国内首次在机器人策略模型中,对Scaling Law进行较为完整的系统验证。
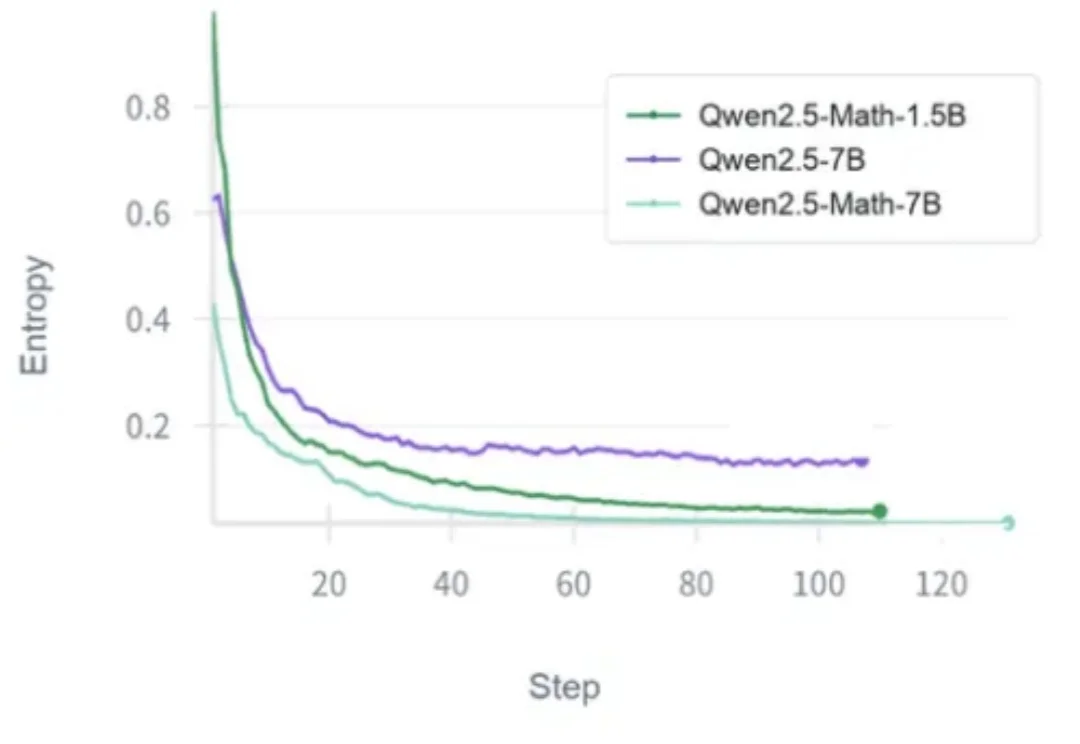
基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)正在成为大模型后训练的关键技术。数学题能判对错,代码能跑测试,可验证奖励让大模型可以通过强化学习持续提升推理能力。