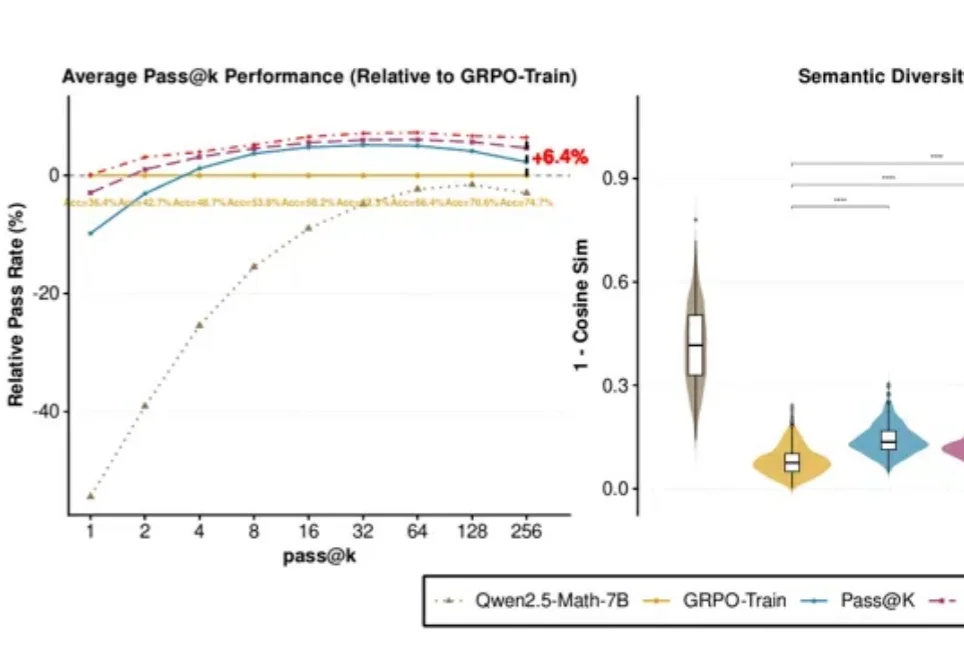
后训练越多模型越“轴”?给参数加点扰动,探索能力回来了 | NeurIPS'26
后训练越多模型越“轴”?给参数加点扰动,探索能力回来了 | NeurIPS'26DeepSeek-R1等模型让人们看到了强化学习的潜力。但已有研究发现,模型答得更准,未必意味着能解出的题目更多。
来自主题: AI技术研报
9037 点击 2026-10-30 10:02

 搜索
DeepSeek-R1等模型让人们看到了强化学习的潜力。但已有研究发现,模型答得更准,未必意味着能解出的题目更多。
本周「十字路口」的嘉宾是李磊,小米 MiMo 大模型后训练研究员、香港大学在读博士。一边参与大模型训练,一边读 PhD,他和许多同学一样,面对着 AI 带来的巨大机会,也置身于飞速变化的节奏中:既兴奋,也焦虑。
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
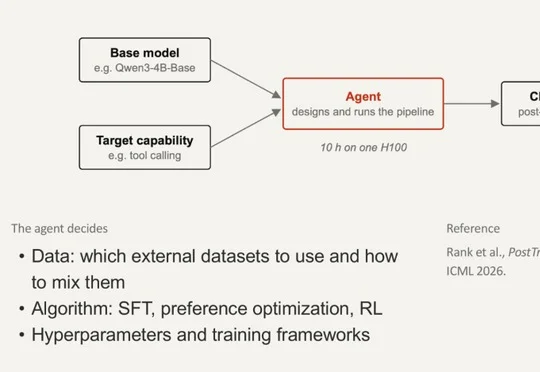
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
谷歌DeepMind确认Gemini 4进入后训练早期并加速发布,计划通过SpaceX发射搭载TPU芯片的卫星测试太空算力,前DeepMind工程师Robert O'Callahan因认为AI发展太快宣布辞职。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
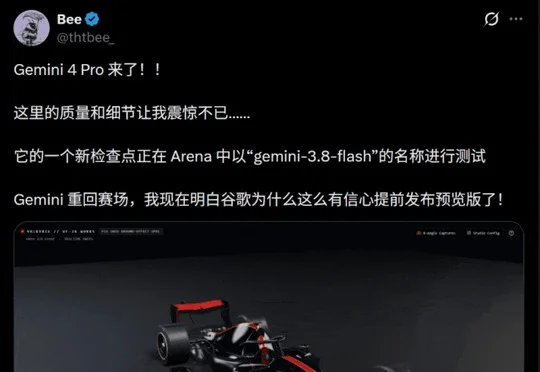
谷歌DeepMind掌门人首次确认Gemini 4 Pro已进入后训练早期阶段,开发者在实测中发现其新检查点在3D物理模拟、代码生成等任务上表现碾压Opus 5.5,且泄露参数显示其具备1000万Token上下文窗口和极具攻击性的定价,谷歌力争在年底前正式发布。
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
最近几个月,后训练成了 AI 行业最集中的议题。