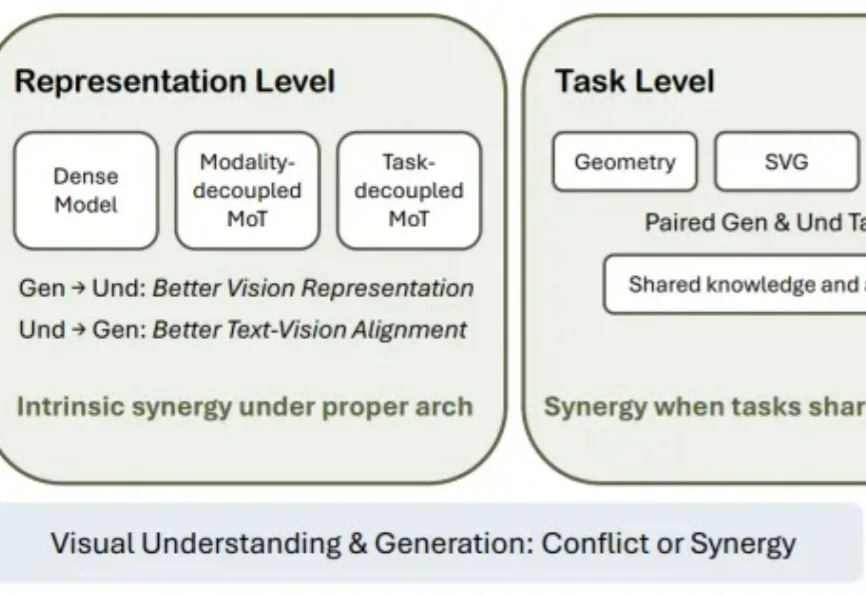
视觉理解和生成究竟能否相互促进?从视觉表征、任务到系统重新审视UMM
视觉理解和生成究竟能否相互促进?从视觉表征、任务到系统重新审视UMM理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
来自主题: AI技术研报
6634 点击 2026-09-14 15:03

 搜索
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
OpenAI发布新一代图像生成模型ChatGPT Images 2.5,在图片细节质量、生成速度、编辑精度及多轮修改一致性上有所提升,并新增Sketch手绘参考、创作模板和图片评论编辑等功能。
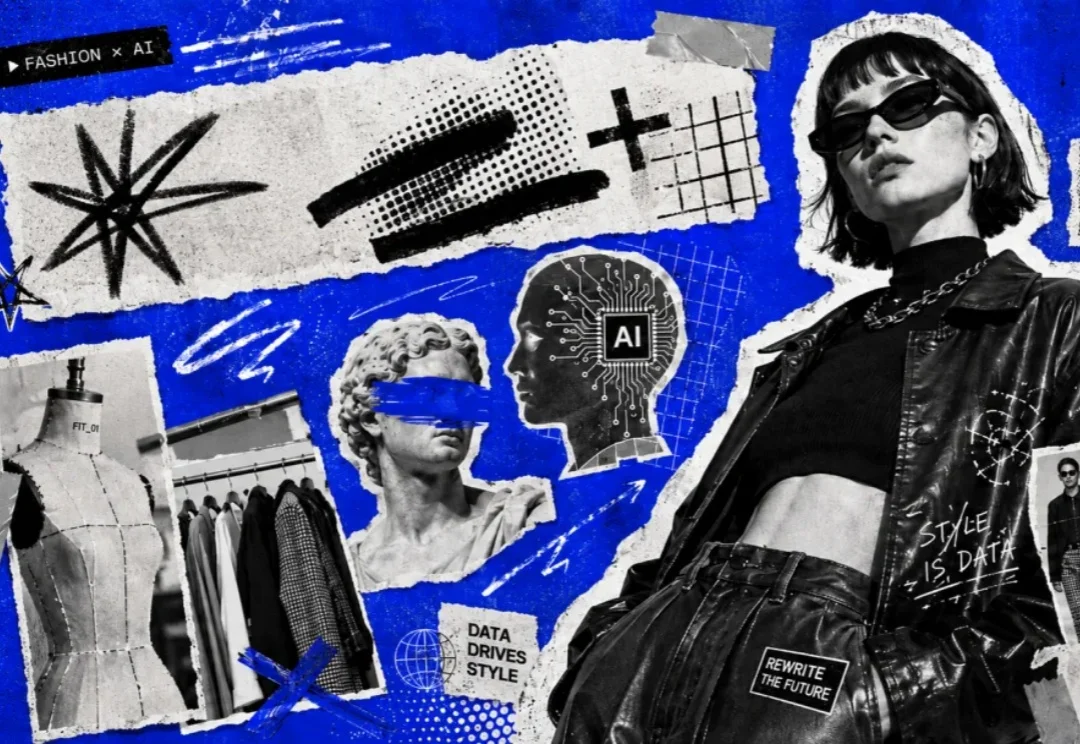
过去两年,AI生图的参数量与清晰度完成了指数级跨越,但真正面向服装行业却依然面临一个极其尴尬的悖论——当GPT、Gemini等顶尖大模型在通用图像生成上大放异彩时,落地到服装产业的深水区,依然满屏是令人出戏的AI味。通用的SOTA模型做得到了“逼真”,却依然做不好“商业”。

图像生成模型正从「会创作」转向「可操作」。

这两天,Arena 平台上突然出现一款神秘的图像生成模型,代号「mona-lisa-1」。有人让该模型「生成一张你的创造者的图片」,模型点名 OpenAI 和奥特曼。且有网友用 OpenAI 验证工具检测生成图片后,确认图片中带有 OpenAI 的 SynthID 水印。

近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。
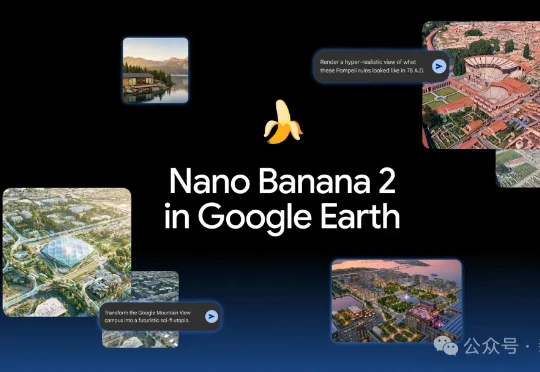
昨天,谷歌把最新图像生成模型Nano Banana 2正式塞进了谷歌地球网页版。谁能想到,一觉醒来,新功能被玩坏,谷歌紧急撤回了这一功能!结果效果太逼真,被专家强烈反对后,谷歌紧急撤回了新功能,「加强防护措施」后再次发布。
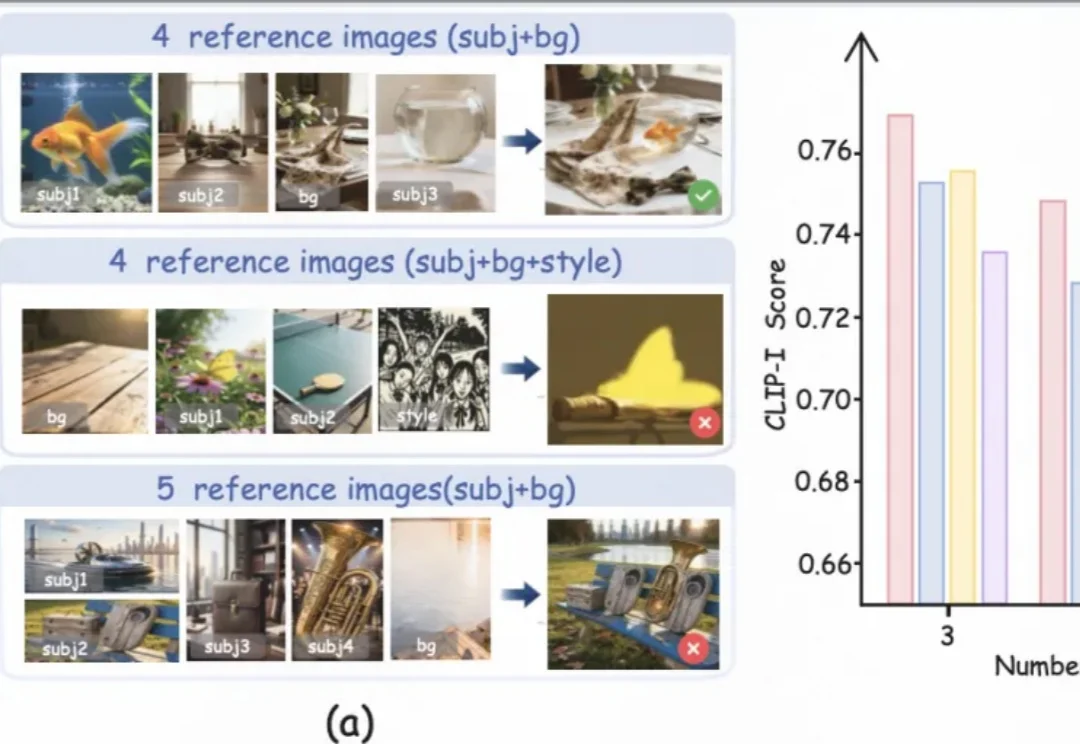
给图像生成模型一张人物参考图,它大概率能抓住身份特征。
今天,阿里通义团队发布了他们第三代图像生成模型:Qwen-Image-3.0 。官方博客用了一个字来概括这一代的核心进步,「实」。不是好看,不是炫技,是「实」。内容丰实、细节真实、知识厚实。
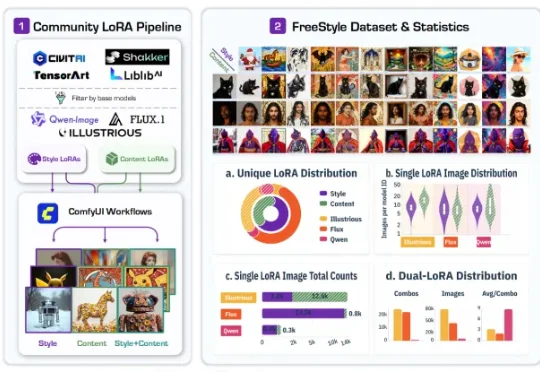
最近,一篇名为 FreeStyle: Free Control of Style-Content Dual-Reference Generation from Community LoRA Mining 的工作引起了不少关注。换句话说,FreeStyle 研究的是 style-content dual-reference generation,也就是「内容 - 风格双参考生成」。