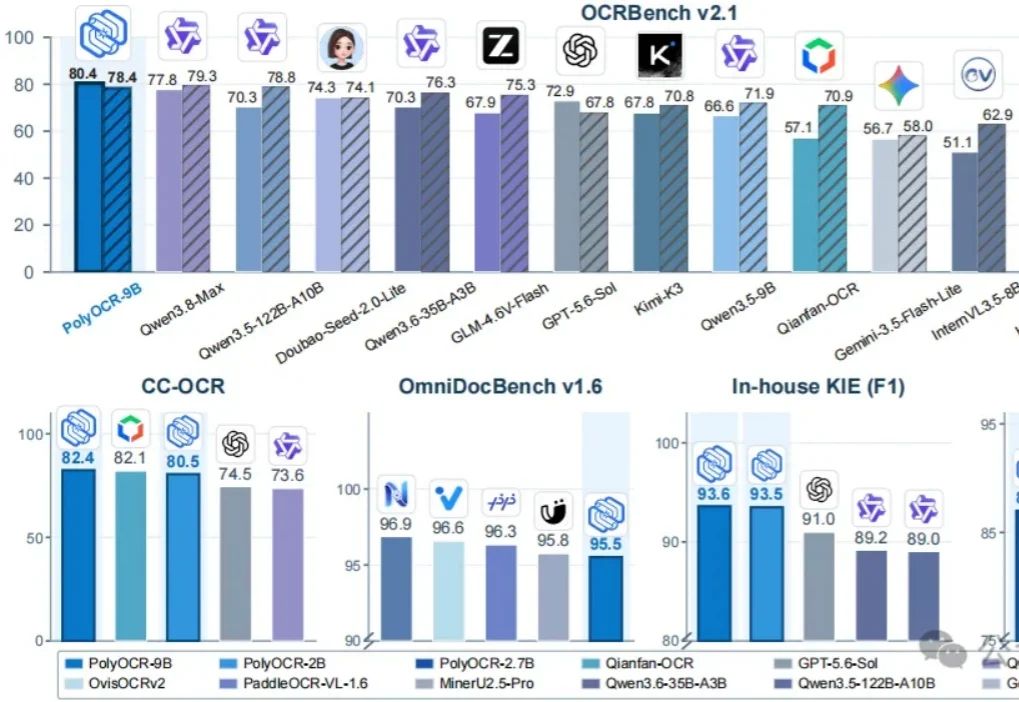
蚂蚁推出OCR大模型:同一架构实现全场景文本智能,2B参数也能打
蚂蚁推出OCR大模型:同一架构实现全场景文本智能,2B参数也能打随着多模态大模型越来越强,OCR的短板反而逐渐明显。
来自主题: AI技术研报
8615 点击 2026-10-29 11:25

 搜索
随着多模态大模型越来越强,OCR的短板反而逐渐明显。
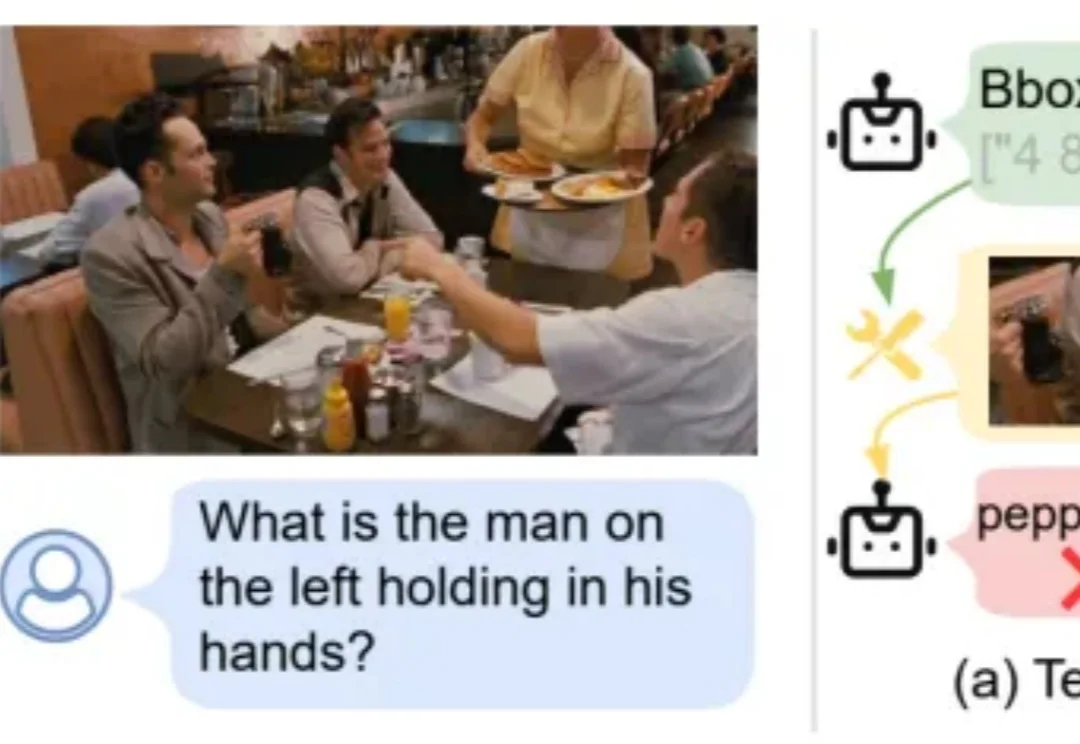
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
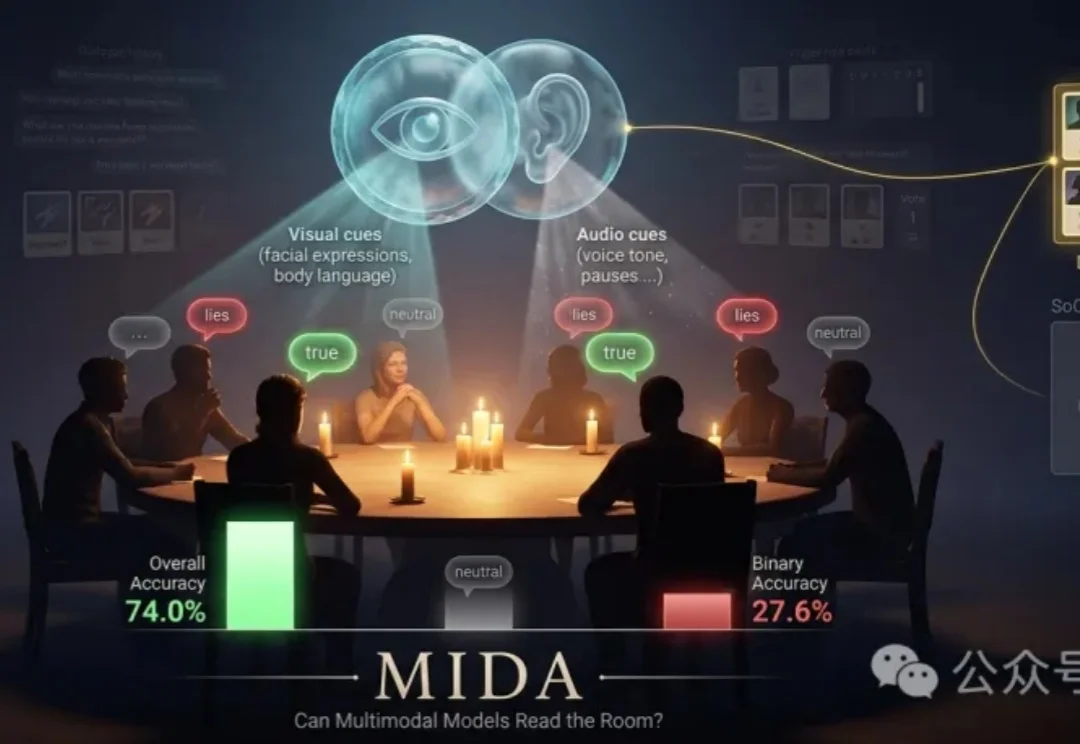
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
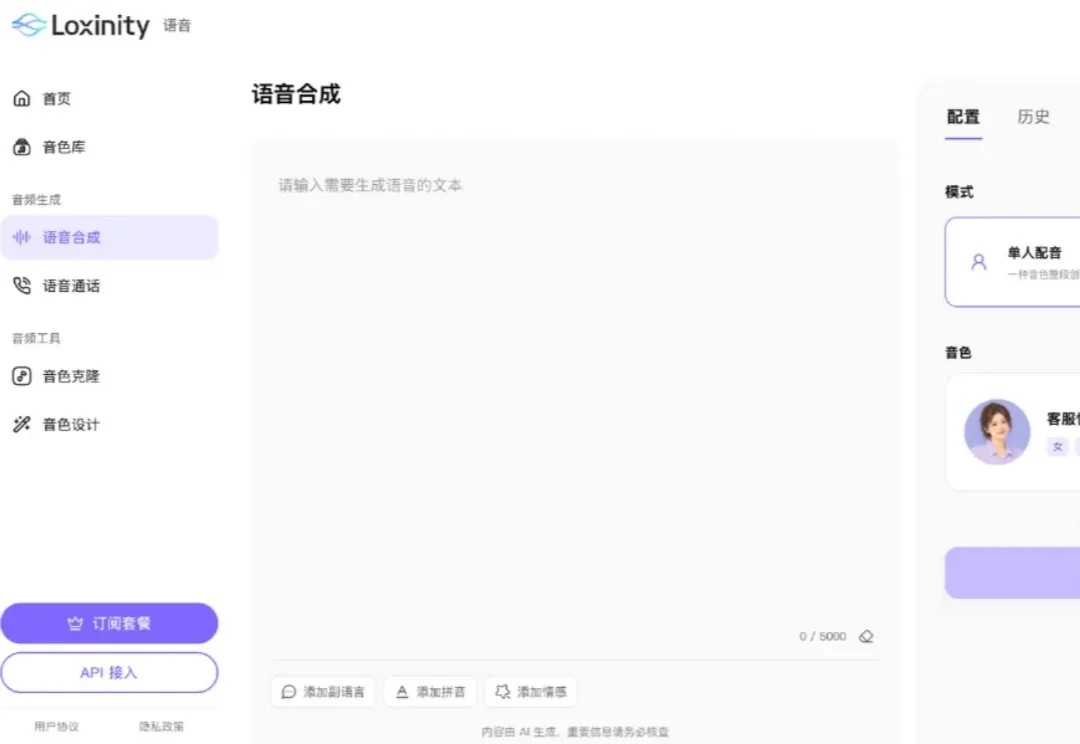
《读佳》独家获知,Soul将推出专为交互场景打造、超具活人感的语音合成产品“Loxinity(洛希无限)”,和市面上面向配音、短视频的TTS不同,这套模型从底层瞄准实时交互场景,主打强活人感。它支持单人配音、多人对话两种模式,配套音色克隆、音色设计等工具,还开放API接入。Loxinity下辖语音合成模型Loxi Speech和视频生成模型Loxi Avatar。
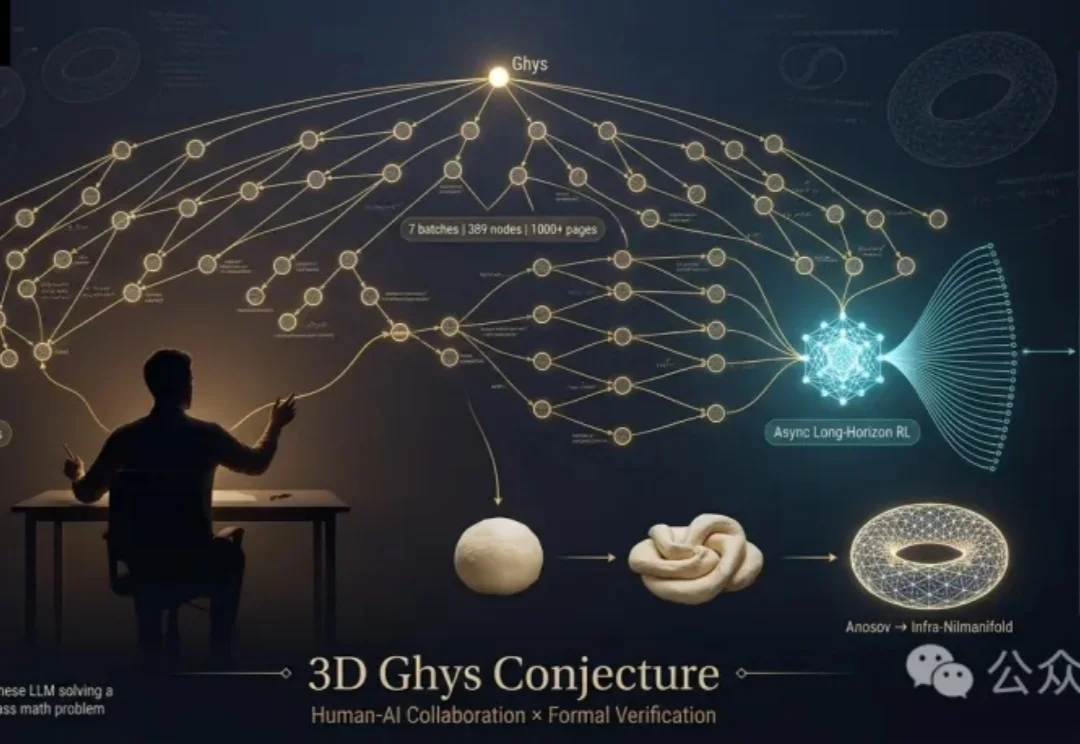
困扰数学界30余年的世界级难题——三维Ghys猜想迎来了破解!
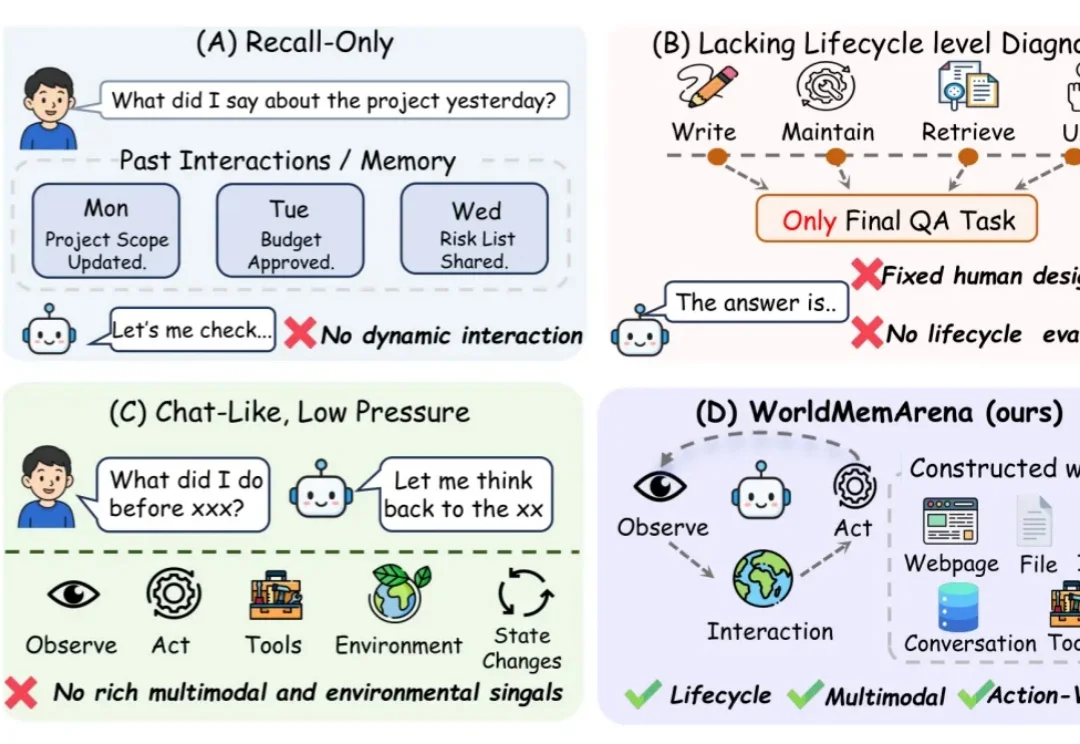
团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?
Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。
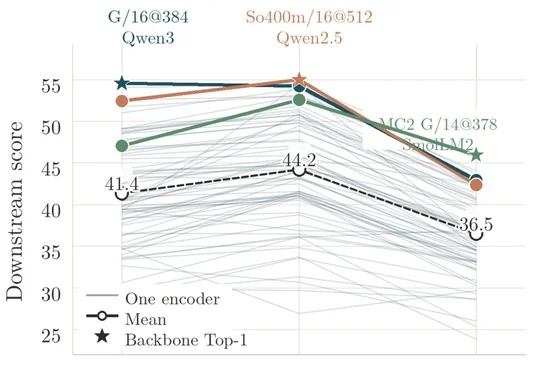
团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
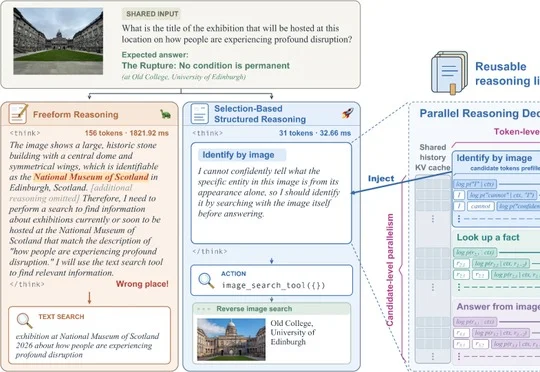
苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。
Z Potentials 独家获悉,Xspark AI(无界智航)近日完成新一轮融资。本轮融资由猎道投资、华山资本、元航资本、浦东创投、钧源资本、南山战新投、水木创投等机构共同参与,多维资本担任本轮融资独家财务顾问。