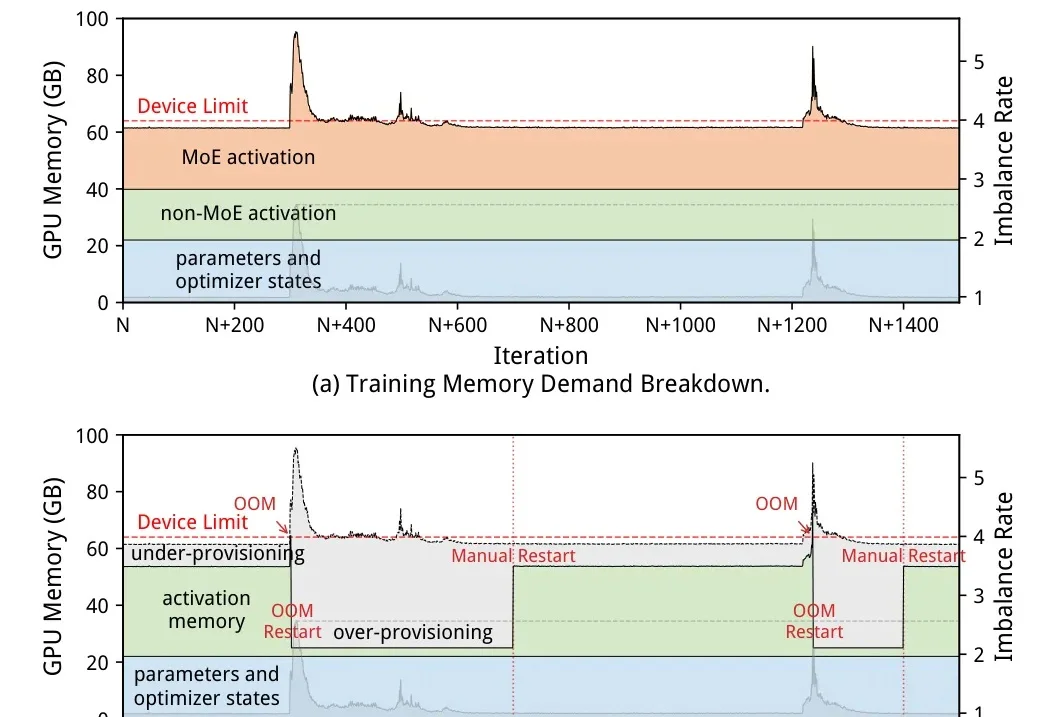
SC26 顶会论文:八卦炉 2—— 让万卡集群学会临场应变
SC26 顶会论文:八卦炉 2—— 让万卡集群学会临场应变大模型训练已经跑到万卡集群规模,显存始终是那道隐形的门槛。
来自主题: AI技术研报
6989 点击 2026-10-28 15:34

 搜索
大模型训练已经跑到万卡集群规模,显存始终是那道隐形的门槛。
本周「十字路口」的嘉宾是李磊,小米 MiMo 大模型后训练研究员、香港大学在读博士。一边参与大模型训练,一边读 PhD,他和许多同学一样,面对着 AI 带来的巨大机会,也置身于飞速变化的节奏中:既兴奋,也焦虑。
五年前中科曙光立项曙光8000时提前押注"超智融合"路线,建成中国首个全国产十万卡AI超集群,将高精度科学计算与AI大模型训练集成于同一系统,近日随央视纪录片《超级工程》完整呈现其五年技术攻关与落地的全过程。
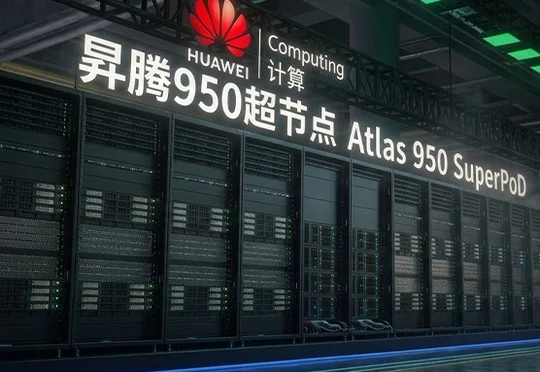
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
大模型训练拼的是算力,Agent训练拼的是环境。
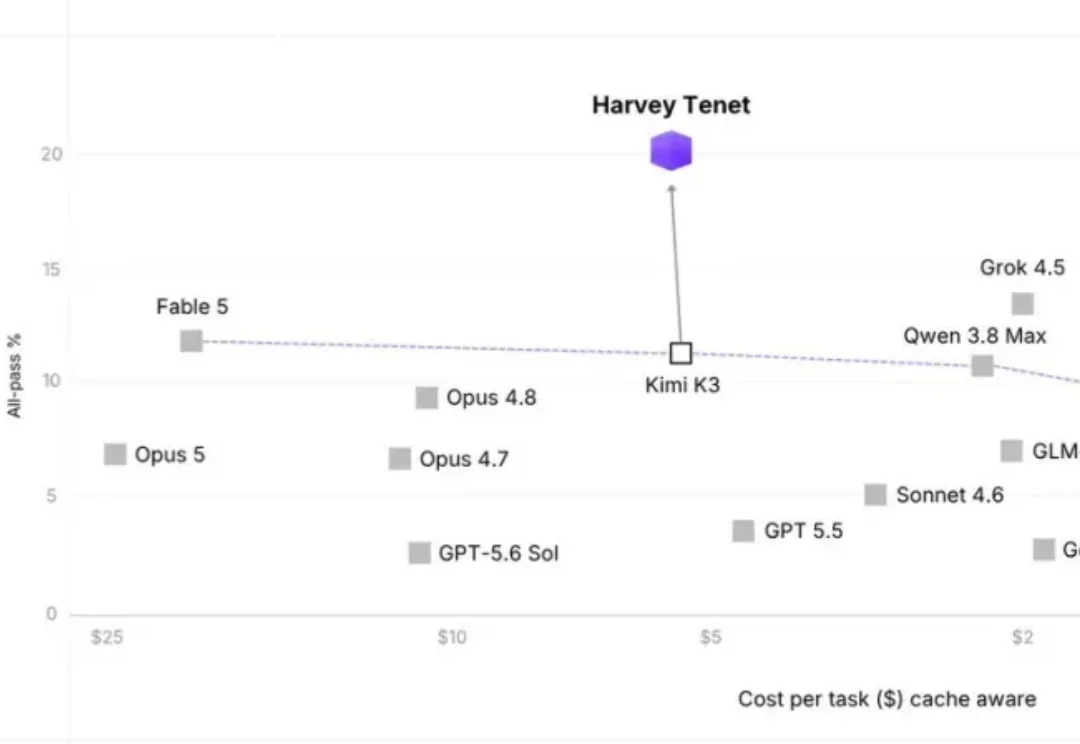
最近,越来越多应用层 AI 企业走上了一条相似的路线:用自己积累的专业知识和业务经验,训练自己的模型。
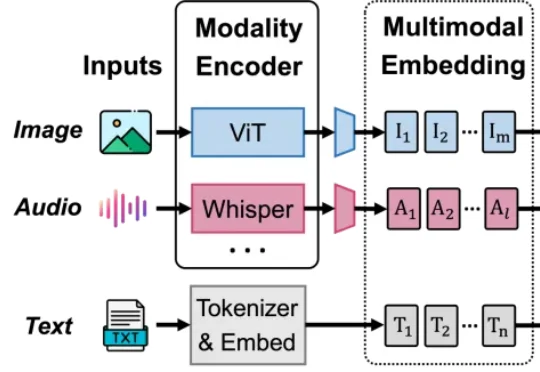
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
如果只看标题,它很容易被归到“又一个万亿参数大模型”的队伍里:1.6 万亿总参数、MoE 架构、100 万 token 上下文、面向代码和 Agent 场景。但这次真正值得看的,不只是模型有多大,而是它背后的三个问题:国产算力能不能支撑前沿级大模型训练?
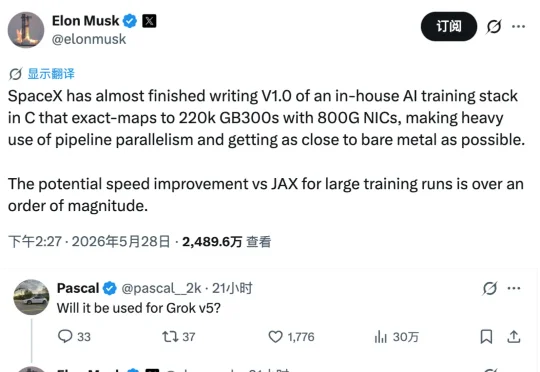
不用JAX,SpaceX正在用C语言编写的全新堆栈训练新模型。而且马斯克本人亲口承认,Grok 5已经用的就是这个新堆栈。按马斯克的说法,这种新堆栈能让大模型训练速度提升一个数量级。
众所周知,大模型训练成本极高。