金融AI的年度大考交卷了:2万名选手、30+家机构、百亿级数据开源
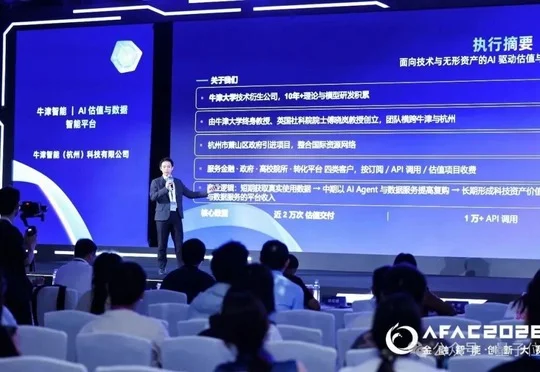
金融AI的年度大考交卷了:2万名选手、30+家机构、百亿级数据开源AFAC2026金融智能创新大赛总决赛落幕,全球5027支队伍近2万名选手参赛,主办方联合30余家机构推出四道贴近真实金融场景的赛题,并正式发布覆盖13万条评测样本的"AFAC百万金融智能数据集"实现百亿级金融科技数据开源。
来自主题: AI资讯
8504 点击 2026-09-04 15:50

 搜索
AFAC2026金融智能创新大赛总决赛落幕,全球5027支队伍近2万名选手参赛,主办方联合30余家机构推出四道贴近真实金融场景的赛题,并正式发布覆盖13万条评测样本的"AFAC百万金融智能数据集"实现百亿级金融科技数据开源。
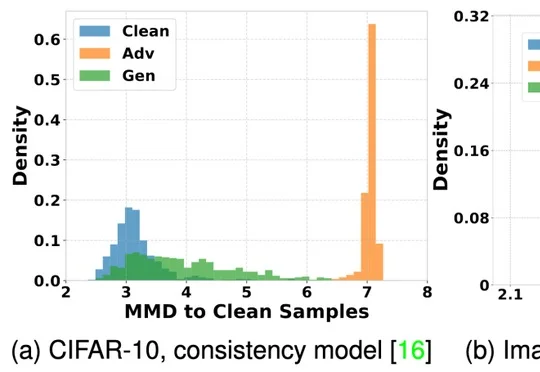
CMAP团队发表于TPAMI 2026的工作提出基于一致性模型的对抗净化方法,将传统像素空间去噪转化为隐空间流形优化,使对抗样本映射回干净数据流形,在多种攻击类型与自适应攻击条件下均有效提升深度神经网络的鲁棒性。
沙特人工智能公司HUMAIN基于中国MiniMax的开源旗舰模型MiniMax M3推出阿拉伯语大模型HUMAIN M3,使用超过1万亿Token阿拉伯语数据进行后训练,在七项阿拉伯语基准测试中等权平均分达89.37%,标志着中国开源模型正成为全球AI生态的底层技术基础。
训练一个大模型之前,语料需要经过解析、清洗、去重、质量评分、Token化和样本组装。
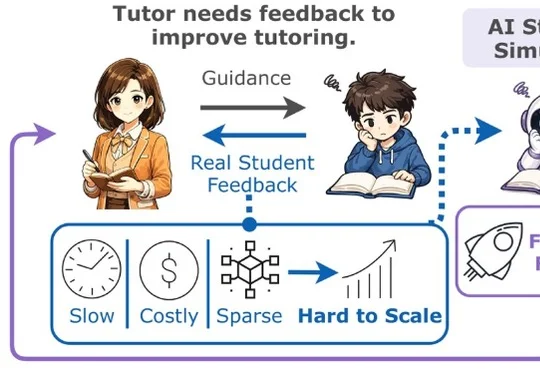
微软与UIUC合作研究StudentSim框架,基于真实学生数据训练个性化学生模拟器,具备behavioral fidelity和guidance responsiveness两项能力,在国际象棋等三个领域验证其优于现有基线,并可作为AI教师强化学习的高通量奖励信号。
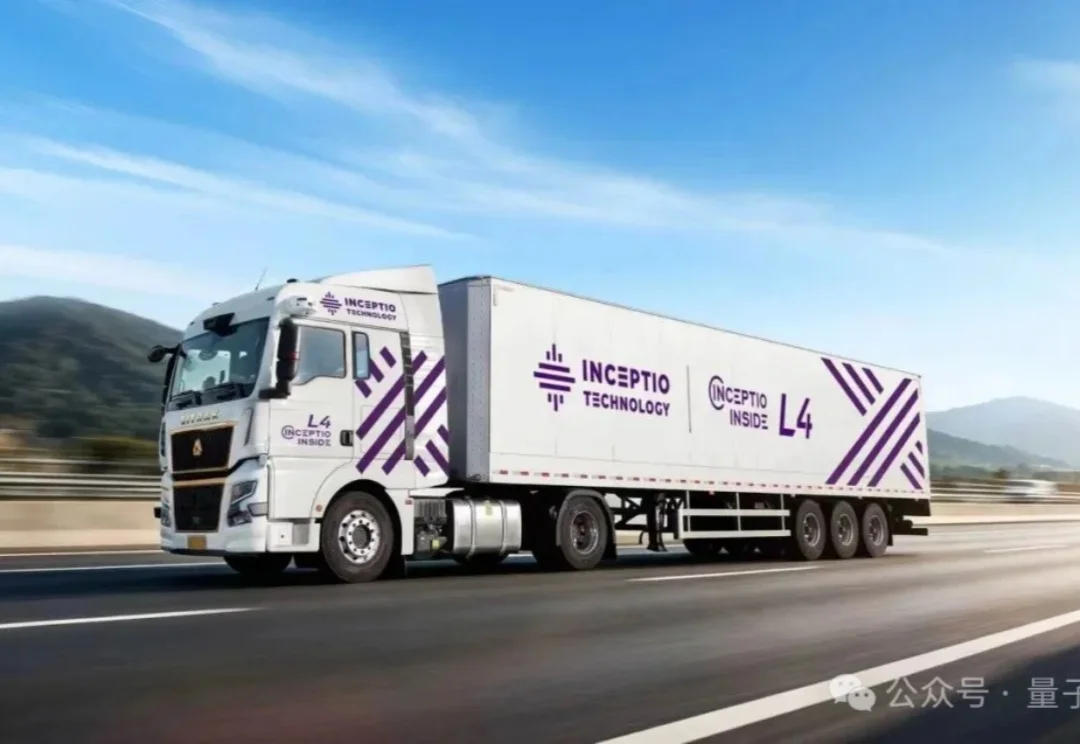
2026年9月3日,嬴彻科技宣布其卡车自动驾驶商业运营里程突破10亿公里,形成行业最大规模的真实运营数据资产。
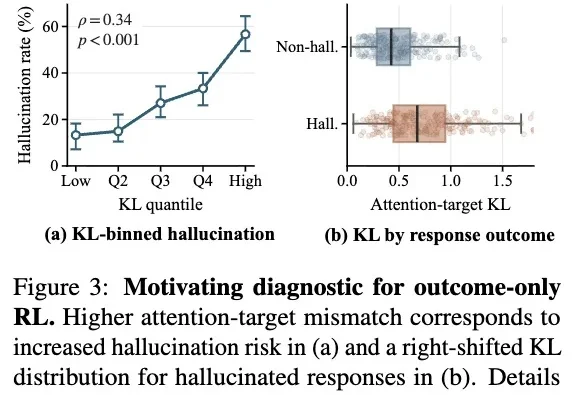
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
由两名00后大学生创办的美国AI训练数据公司AfterQuery五个月内估值从3亿美元升至32亿美元,其数据已用于英伟达Nemotron 3 Ultra模型训练,并与Thinking Machines Lab、Legora及部分中国AI实验室合作。
除了电力之外,在这一轮AI数据中心扩产潮中,中国另外两个天然优势,也被海外发现了。