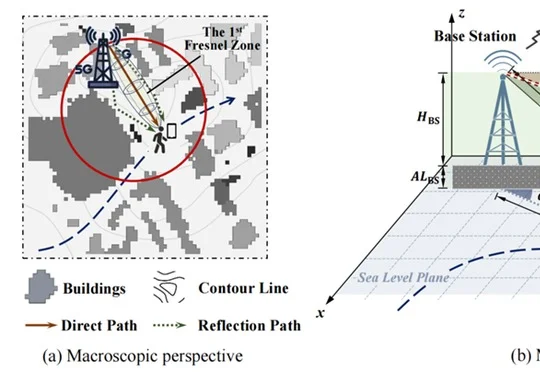
清华发布物理引导的扩散模型,无线信道多尺度预测提升37.19% | TMC'26
清华发布物理引导的扩散模型,无线信道多尺度预测提升37.19% | TMC'26清华大学与北京邮电大学联合提出物理引导扩散模型Channel-Diff,将传播模型、阴影遮挡与多径几何嵌入条件扩散模型,实现无线信道多尺度RSRP预测,在两套真实数据集上相较次优方法分别取得37.19%和25.15%的综合性能提升。
来自主题: AI技术研报
7455 点击 2026-09-13 12:58

 搜索
清华大学与北京邮电大学联合提出物理引导扩散模型Channel-Diff,将传播模型、阴影遮挡与多径几何嵌入条件扩散模型,实现无线信道多尺度RSRP预测,在两套真实数据集上相较次优方法分别取得37.19%和25.15%的综合性能提升。

GPT-6爆火的人体解剖3D案例被扒出实际调用了现成3D数据集素材而非真正生成,文章作者通过GPT-6搭配Hyper3D MCP,用Codex调用Hyper3D Rodin模型实际复刻出可交互的3D人体拆解网页,并延伸制作了可拆装蒸汽甲壳虫、橘猫子弹时间、骑楼街景和影子解谜游戏等多种3D交互作品。
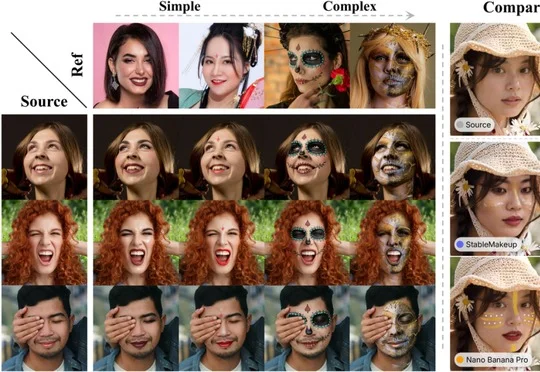
ECCV 2026论文ART由vivo BlueImage Lab联合哈工大与南大提出,通过将真实参考图作为可微分监督信号的两阶段训练框架,突破了复杂妆容迁移中的伪目标天花板,同步发布了首个2K分辨率妆容数据集MF2K。
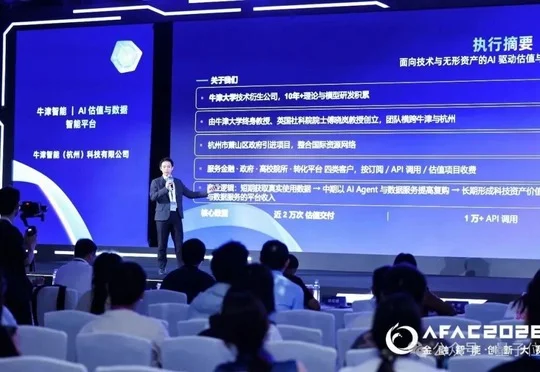
AFAC2026金融智能创新大赛总决赛落幕,全球5027支队伍近2万名选手参赛,主办方联合30余家机构推出四道贴近真实金融场景的赛题,并正式发布覆盖13万条评测样本的"AFAC百万金融智能数据集"实现百亿级金融科技数据开源。
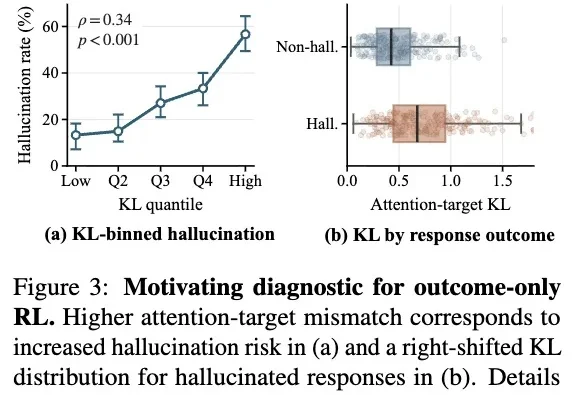
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
据 Business Insider 报道,人工智能开源平台 Hugging Face 正探索出售事宜,交易估值有望达到 130 亿美元(约合人民币 876.6 亿元)。该公司总部位于纽约,目前托管着大量开源大语言模型和数据集,并已聘请投行协助评估潜在竞购方意向。

天使轮由一线美元基金,智能制造与大模型产业方共同领投;数据集 Xperience-10M 位列全平台数据集榜第 2 名,具身赛道第一名,目前已被多款具身基础模型 Qwen-VLA、MolmoMotion 等采用;多模态采集系统 HOMIE 进入规模化量产交付,新一代系统将于 2026 年 8 月发布。
2009年,李飞飞团队正式发布ImageNet。
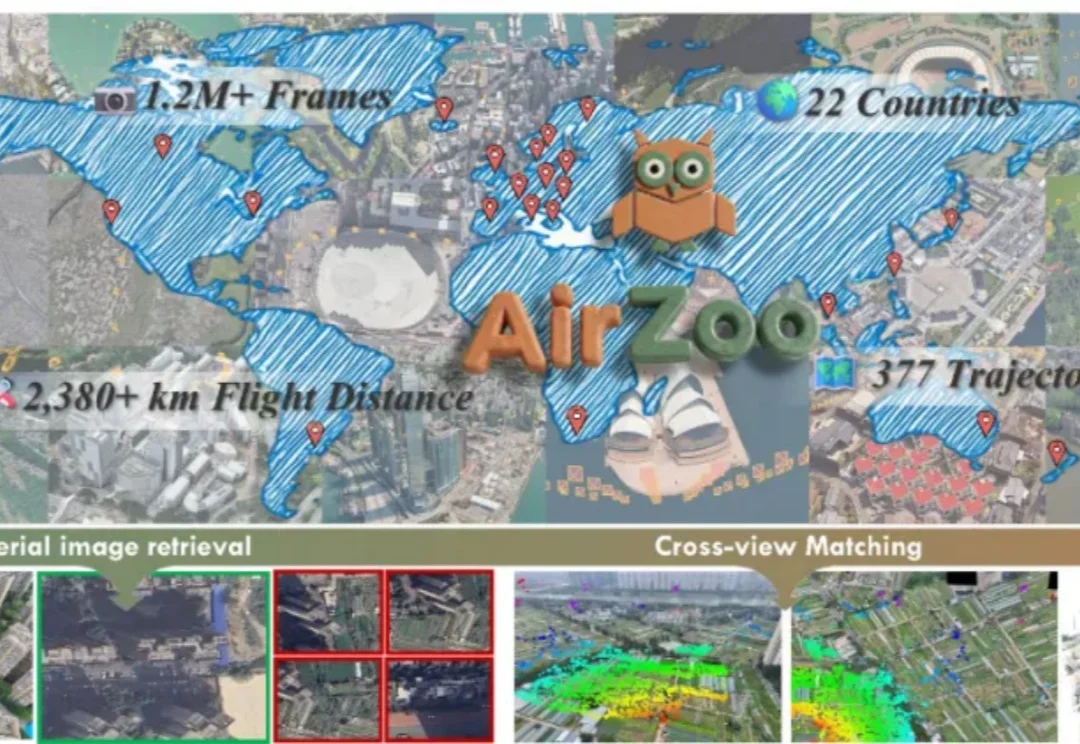
国防科技大学虚拟现实与视觉计算团队(SAW Lab)联合先进制导与控制技术国家级重点实验室等推出面向航拍几何 3D 视觉的统一大规模数据集与评测基准 「AirZoo」。
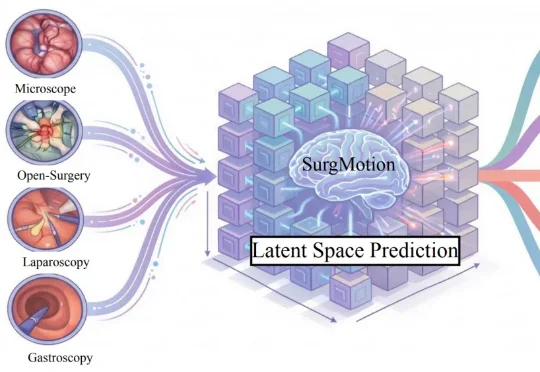
手术 AI 正在从 “单帧感知” 迈向 “全流程视频理解” 的全新时代!近日,由中国科学院香港创新研究院人工智能与机器人创新中心领衔,发布了全球首个十亿级参数、最大规模数据集练成的手术视频原生基础模型 ——SurgMotion!