
openJiuwen首发双维度RSI框架,AI自修改,落地办公智能体,算力亲和助力又快又省
openJiuwen首发双维度RSI框架,AI自修改,落地办公智能体,算力亲和助力又快又省openJiuwen首发双维度RSI框架,在WorkSwarm蜂群办公智能体上落地Harness与Artifacts双维度优化,支持科研论文和算法程序两类交付产物迭代,并依托昇腾算力亲和能力降低多轮优化的时延与资源开销。
来自主题: AI技术研报
8701 点击 2026-09-11 15:58

 搜索
openJiuwen首发双维度RSI框架,在WorkSwarm蜂群办公智能体上落地Harness与Artifacts双维度优化,支持科研论文和算法程序两类交付产物迭代,并依托昇腾算力亲和能力降低多轮优化的时延与资源开销。

近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
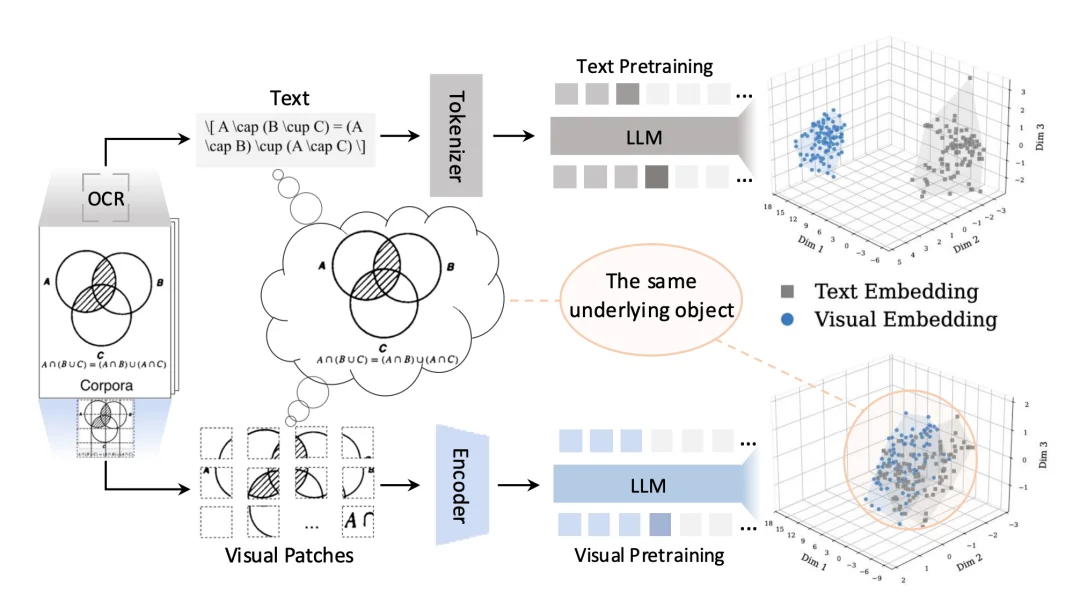
目前,这项技术已成功应用于上海人工智能实验室Intern-S2-Preview 35B/397B系列多模态大模型的预训练中,有效提升了模型的科学推理与多模态理解能力。值得一提的是,相关研发均基于国产昇腾算力平台完成,并成功实现了面向大规模预训练的深度适配与优化。
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。
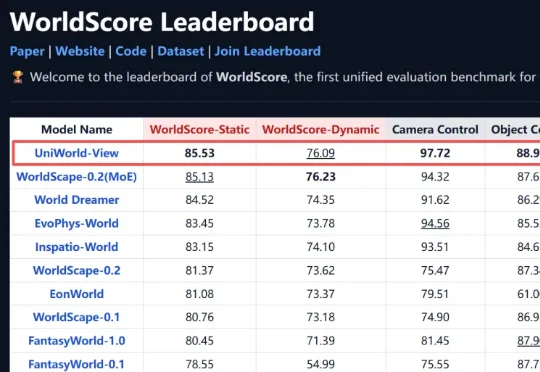
最近,兔展智能联合北京大学、鹏城实验室研发的 UniWorld-View 登顶李飞飞团队 WorldScore 世界模型榜单(训练数据来自北大系初创企业元空智能),并完成国产昇腾算力适配与代码、权重开源。
近期,深圳河套学院(SLAI)AI训练平台项目团队,联合哈尔滨工业大学(深圳)、深圳大数据研究院、华为GTS(全球技术服务)团队与深智城AI算力平台,仅用1个月,共同基于昇腾910C国产算力集群实现DeepSeek-V4-Pro全参数续训练/SFT稳定运行,完成长稳训练1500+步,训练MFU超30%,关键训练算子效率提升14%。
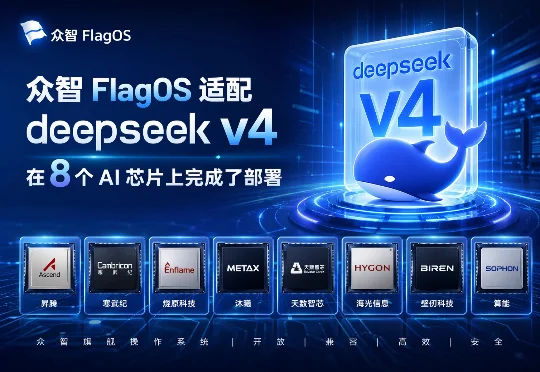
由智源研究院牵头研发的众智 FlagOS 第一时间对两个“巨无霸”模型进行全量适配,已经完成 DeepSeek-V4-Flash 在8款以上 AI 芯片上的全量适配与推理部署,包括海光、沐曦、华为昇腾、摩尔线程(FP8)、昆仑芯、平头哥真武、天数、英伟达(FP8)等芯片。FlagOS 同时正在推进 DeepSeek-V4-Pro 模型在多个芯片的迁移适配,晚些时间开源出来,敬请期待。
MiniMax M2.7 在今天正式开源。我们和华为昇腾、摩尔线程、沐曦、昆仑芯、NVIDIA,以及 Together AI、Fireworks、Ollama 等海内外芯片厂商、推理平台携手,在开源首日即完成模型接入与推理适配工作,推动全球 AI 生态繁荣发展。
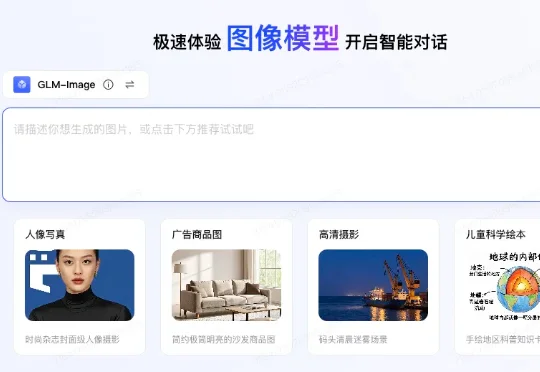
今天,首个在国产芯片上完成全程训练的SOTA(最佳水平)多模态模型开源。这是智谱联合华为开源的图像生成模型GLM-Image。从数据到训练的全流程,该模型完全基于昇腾Atlas 800T A2设备和昇思MindSpore AI框架完成构建。
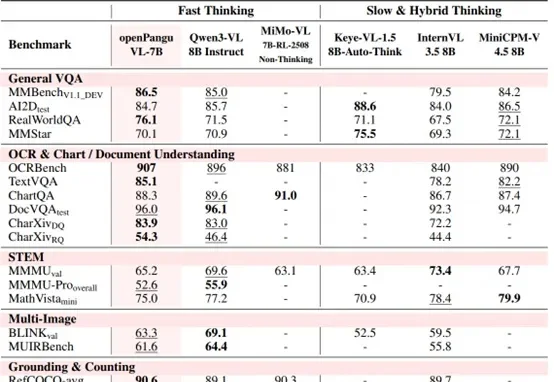
7B量级模型,向来是端侧部署与个人开发者的心头好。