
中科院×字节提出直播间模拟器:让大模型还原用户如何被环境一步步改变 | EMNLP'26
中科院×字节提出直播间模拟器:让大模型还原用户如何被环境一步步改变 | EMNLP'26大模型在直播场景模拟用户行为,理解真实的社交动态和风险演化,是当前一个非常热门的研究话题。
来自主题: AI技术研报
9681 点击 2026-09-11 10:15

 搜索
大模型在直播场景模拟用户行为,理解真实的社交动态和风险演化,是当前一个非常热门的研究话题。
WalkingLab 是由清华大学与香港大学团队发起的开源非营利实验室,专注真实世界 AI 与项目制学习,成立五个月已推出涵盖工程实践、强化学习和大语言模型的三门核心课程,累计获超 20,000 GitHub Star 并登上 Hacker News 首页,致力于通过真实项目连接课程、论文与工程实践,加速 AGI 到来。
RunningHub推出开源的H3 Lightning加速方案,在保留BF16满血精度的前提下使MiniMax H3视频生成速度提升约12倍,依托RH后训练加速模型、SageAttention2等工程优化并针对无NVLink的PCIe多卡环境调优,目前已全部开源至GitHub,支持创作者本地部署。
到底是谁家的模型?
刚刚,DeepSeek 开源了 V4.1 Flash,原生支持视觉理解,也是全新架构系列中最小的一款模型,550B 总参数,输入时激活 8B,输出时激活 16B(你没看错,输入输出激活不同)
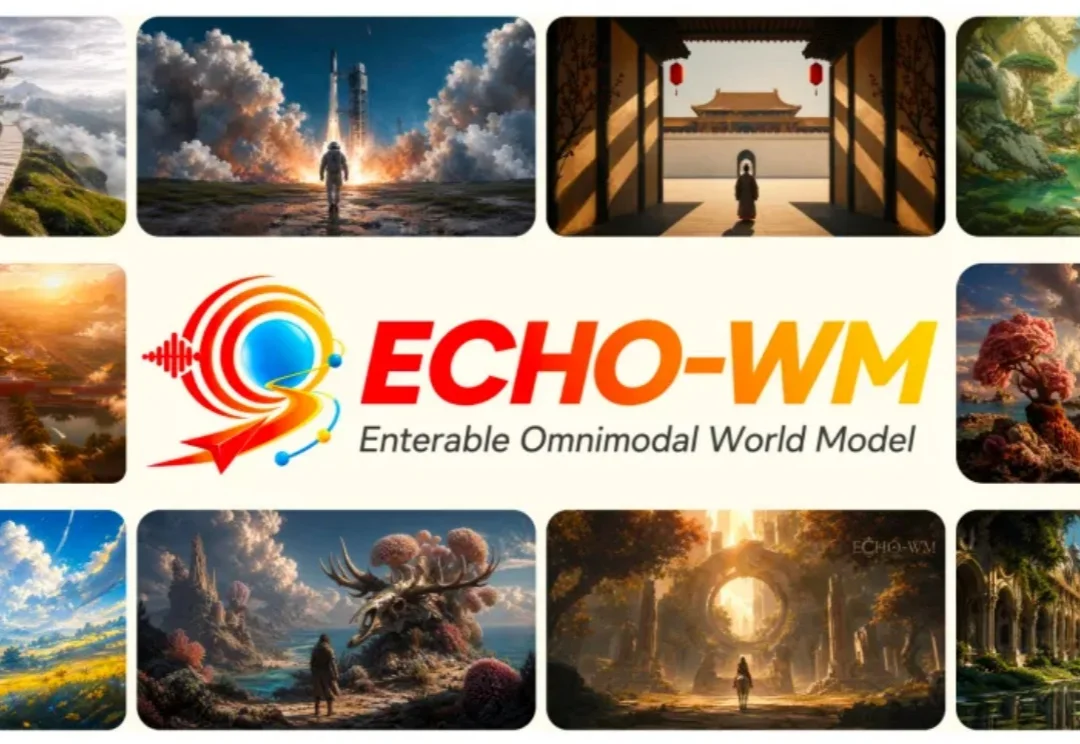
进入到 2026 年,可交互世界生成面对一道更难的考题:AI 生成的世界能否经得起用户反复探索?一扇门画得逼真,只是起点。往前走,它要自然靠近;穿过走廊再回头,它还应该留在原来的位置。用户每一次移动、转身和折返,都在检验模型是否有能力记住已经生成的世界。
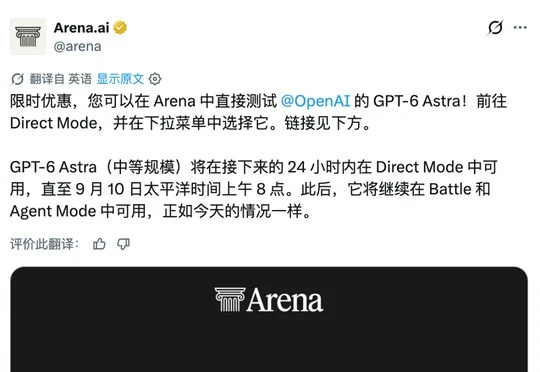
AI大模型评测平台Arena宣布用户可在直接模式中限时免费使用GPT-6 Astra(仅限medium级别),大量开发者涌入体验开发游戏,目前该模型在Agent Arena榜单中整体排名第二、前端网页开发排名第一。
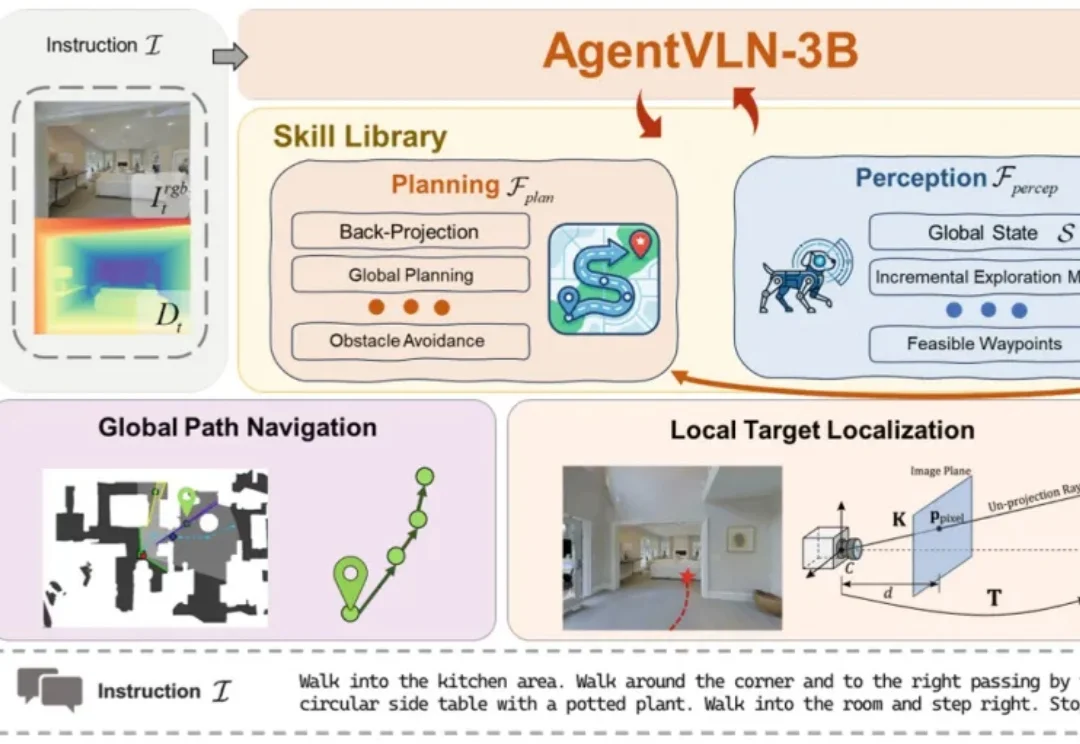
近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
一周之内大语言、图片、视频模型都迎来新赛季:OpenAI的GPT-6 Astra让编码 Agent更好地使用游戏引擎和Blender,自己改场景、自己跑、自己测;GPT-image-2.5上线,更快更强,图片编辑和关键帧动画显著提升;fal和Yoroll分别发布 H3 MaxTurbo和H3 Superfast后训练加速模型,5秒视频3秒内推理,实时生成和互动玩法纷纷涌现。
AI教师已经可以完成不少单次教学任务。