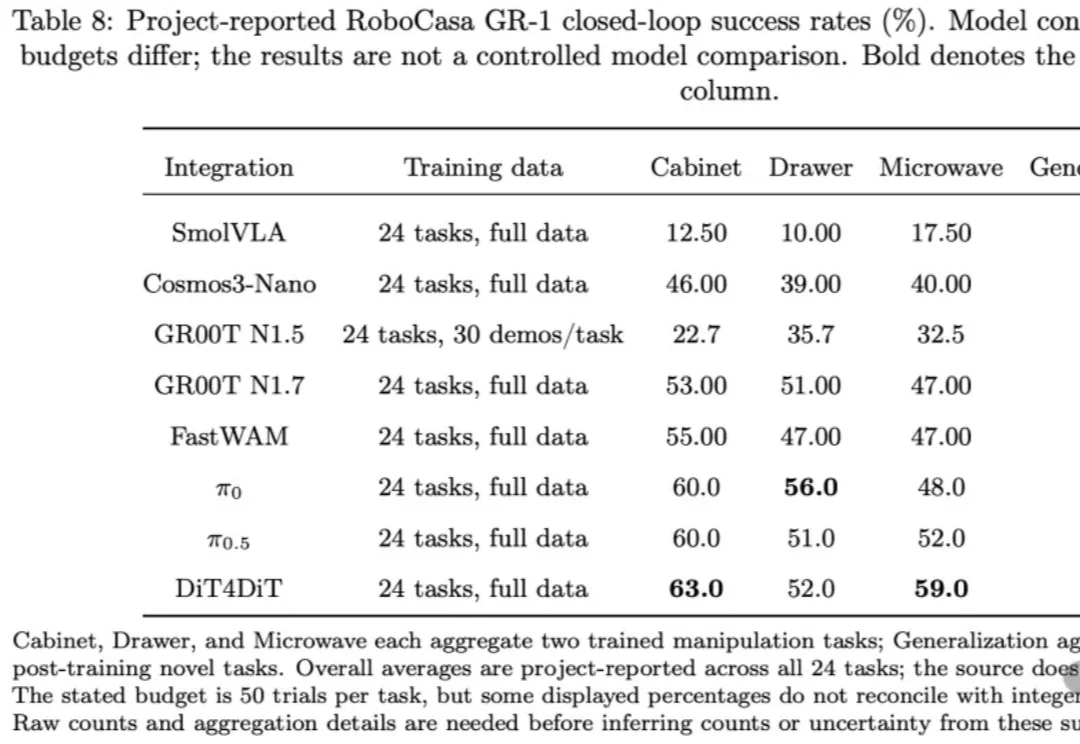
工程能力一键复用,专心卷新能力!轮子造一次就够了|详解FluxVLA Engine技术报告
工程能力一键复用,专心卷新能力!轮子造一次就够了|详解FluxVLA Engine技术报告什么时候是具身智能的ChatGPT时刻?
来自主题: AI技术研报
7079 点击 2026-10-29 11:48

 搜索
什么时候是具身智能的ChatGPT时刻?
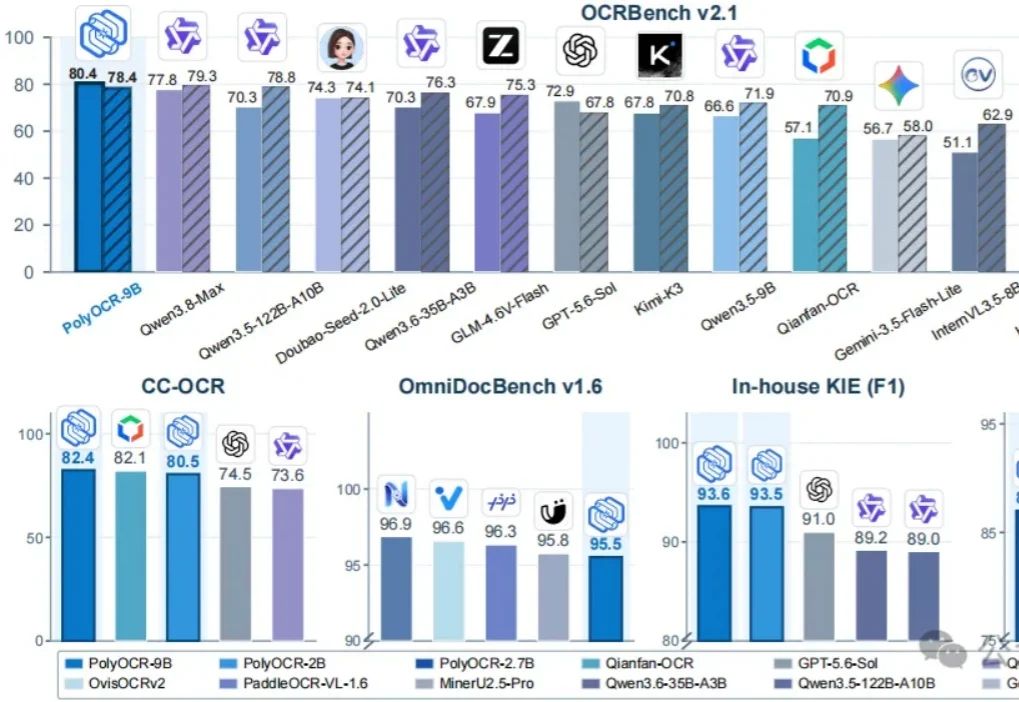
随着多模态大模型越来越强,OCR的短板反而逐渐明显。
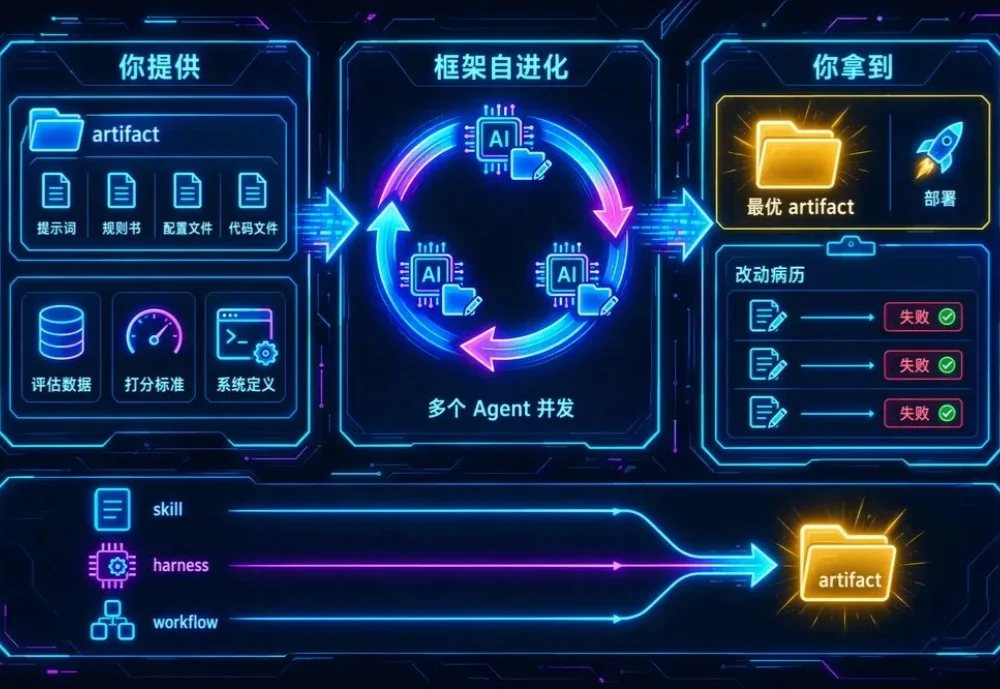
每个做 AI 系统的人都经历过这个阶段:效果上不去,又不知道往哪使劲——读轨迹、改 prompt、调配置,靠人一轮轮试,一试就是好几天。
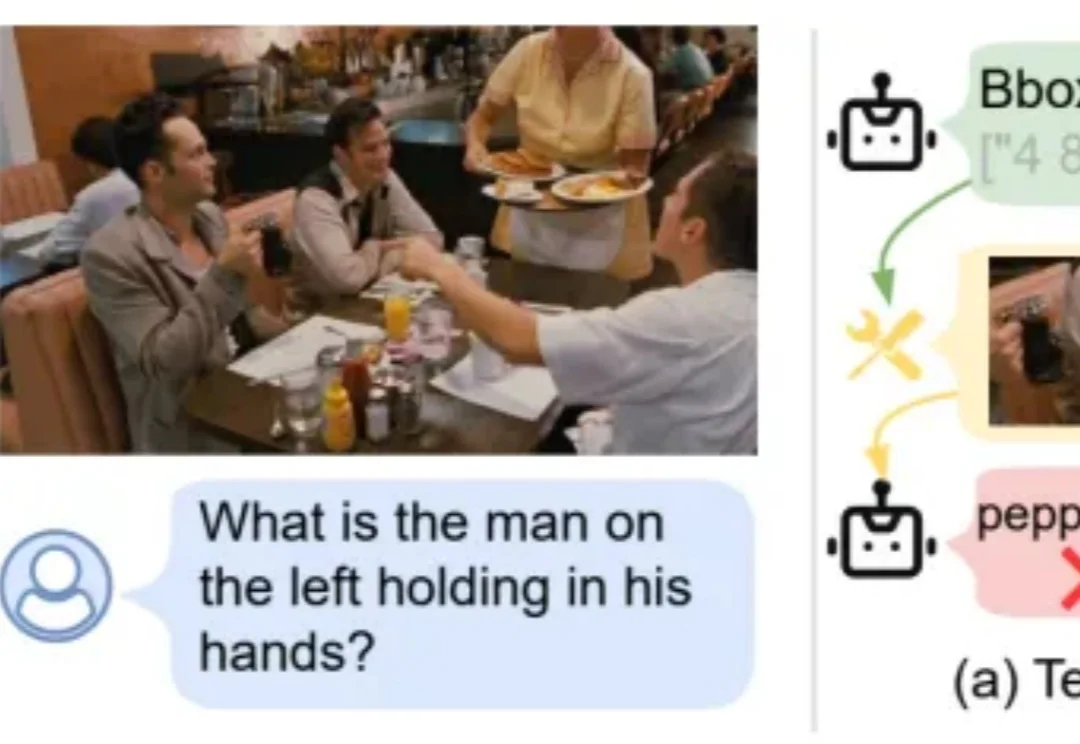
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
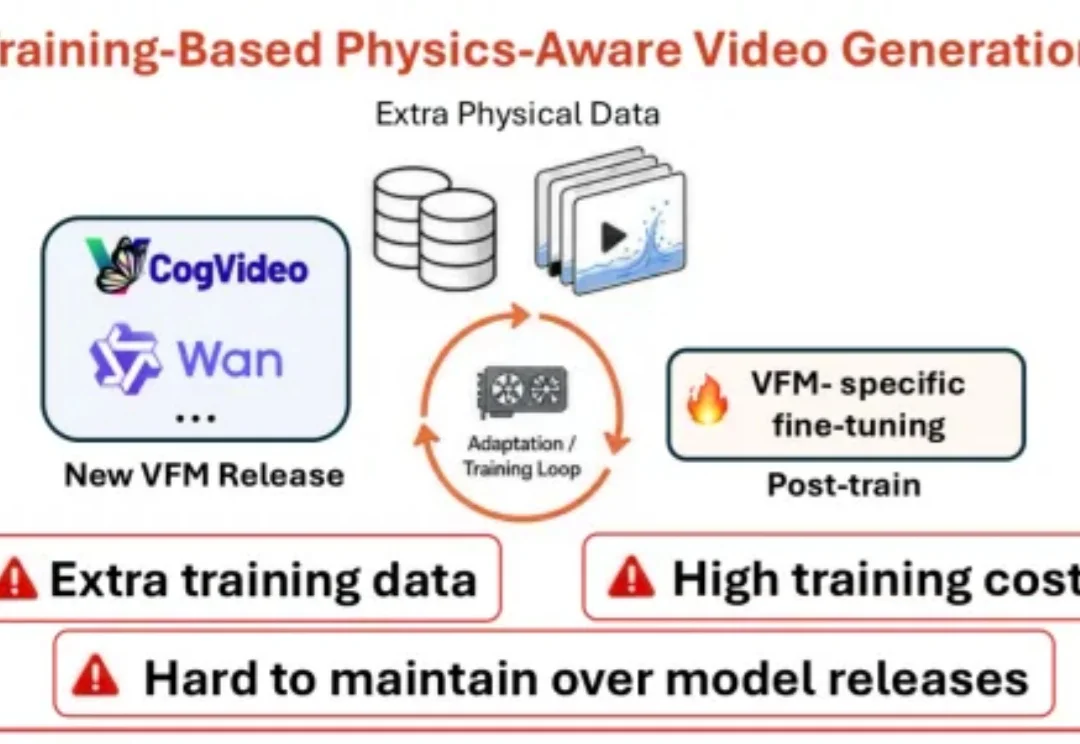
一颗梨在液体中快速旋转,周围的液体应该随之流动、飞溅;一个物体撞向水面,液体也应该产生与碰撞相对应的响应。
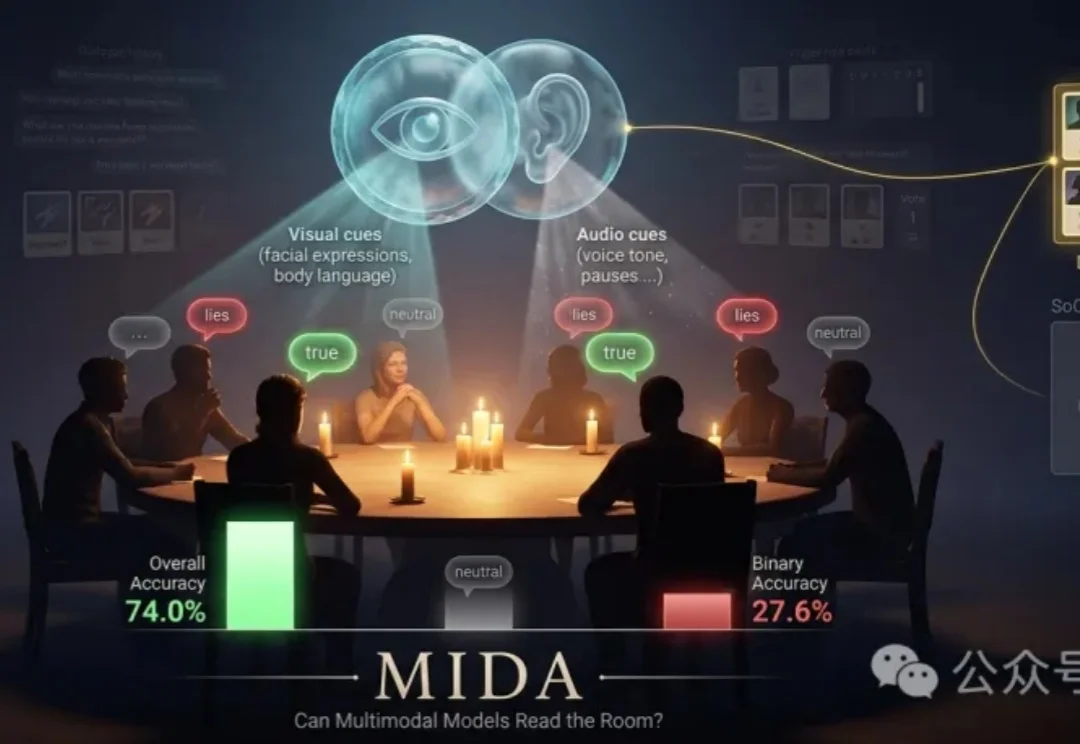
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
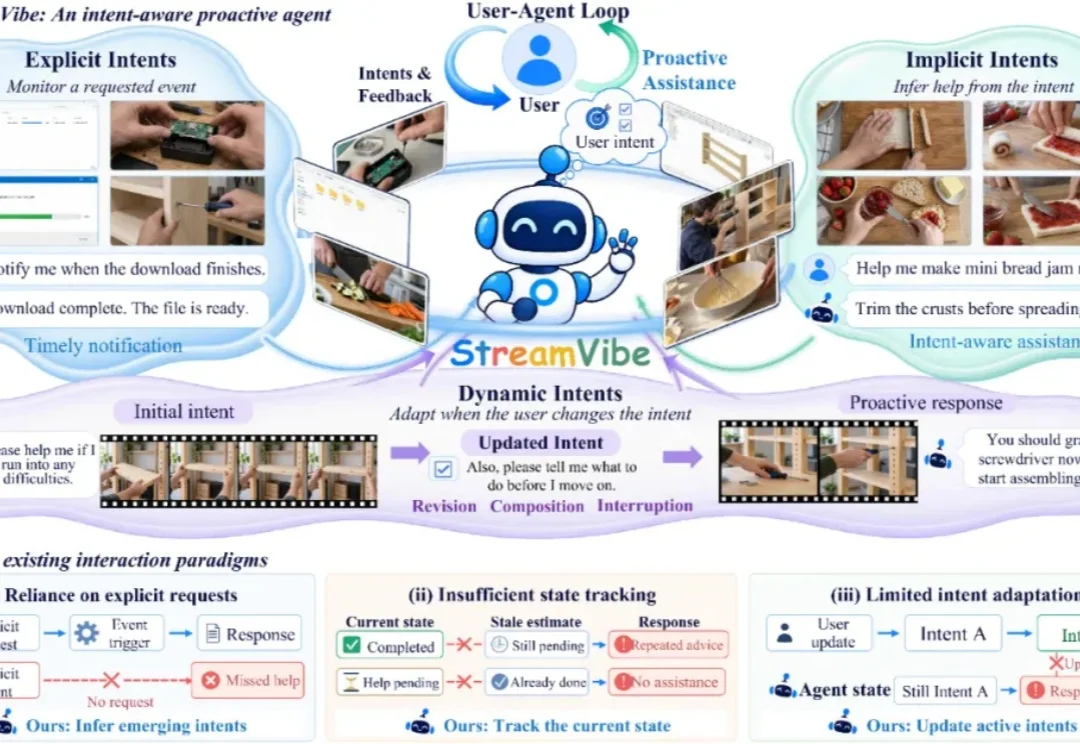
近期,Meta 的 Muse、OpenAI 的 Dot 等产品相继推出,让 Personal Agent(个人智能体)再次成为大模型领域的关注焦点。相比传统的对话助手,这类 Agent 不再局限于回答问题,而是能够结合用户的个人背景、历史记忆与应用上下文,主动执行任务并持续推进长期目标。一个更具主动性、能够长期陪伴用户的 AI 助手,正在逐渐成为现实。
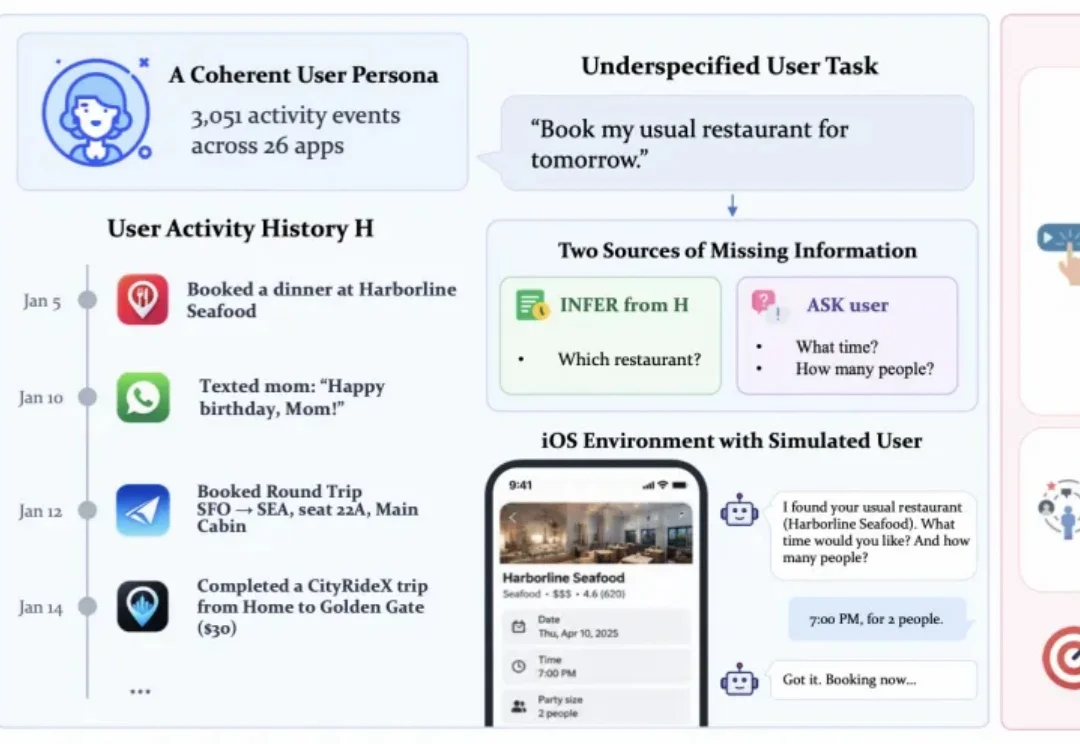
Personal Agent 目前已经能够独立完成许多复杂操作,但在决策时仍面临一个问题:什么时候应该直接推断,什么时候需要向用户追问。
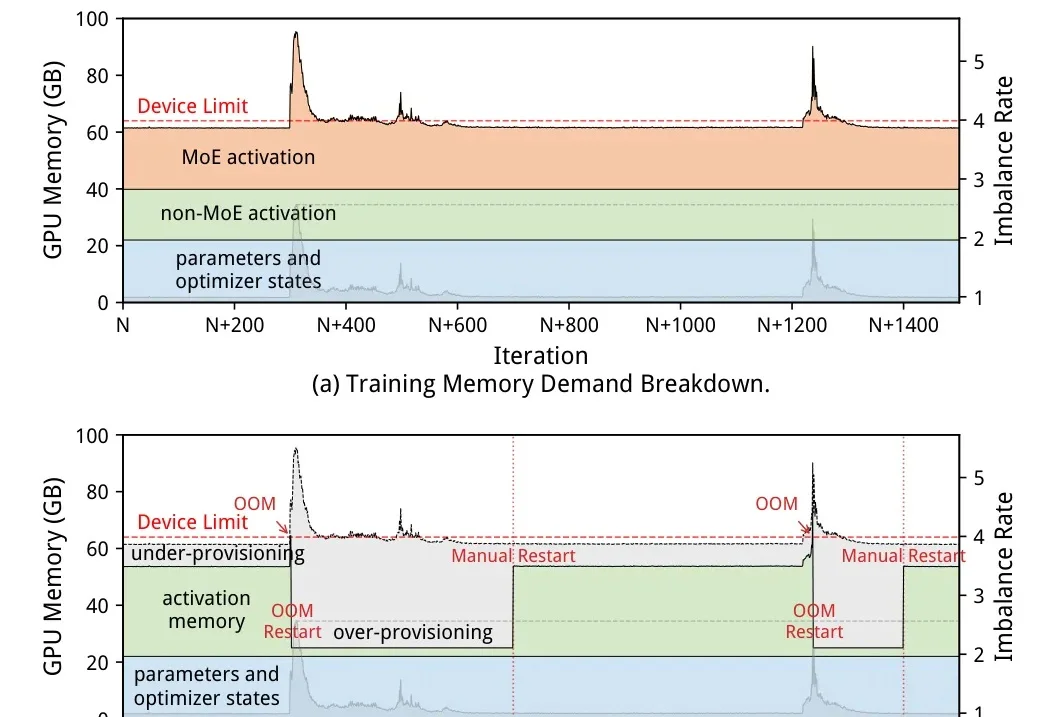
大模型训练已经跑到万卡集群规模,显存始终是那道隐形的门槛。
现实版《盗梦空间》,真的来了!