AI自己出题自己练!两个月狂涨11%,编码自测反超Opus 4.8
AI自己出题自己练!两个月狂涨11%,编码自测反超Opus 4.8Ornith-1.5采用模型自出题、自搭脚手架、自跑轨迹的三段式强化学习闭环,在Terminal-Bench 2.1自测中以86.1分超过其自测的Claude Opus 4.8(85.0分),较两个月前的1.0版本提升约11%。
来自主题: AI资讯
8811 点击 2026-08-30 14:10

 搜索
Ornith-1.5采用模型自出题、自搭脚手架、自跑轨迹的三段式强化学习闭环,在Terminal-Bench 2.1自测中以86.1分超过其自测的Claude Opus 4.8(85.0分),较两个月前的1.0版本提升约11%。
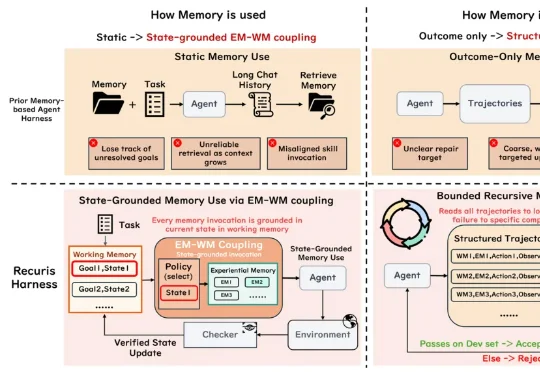
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。
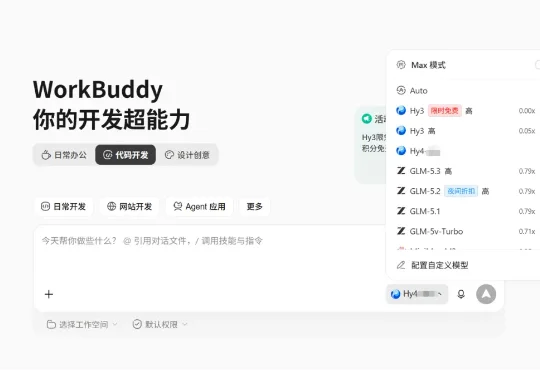
那这次发布的 Hy4 Preview 到底有什么进步,APPSO 这就给你实测看看。姚顺雨此前反复提到一个思路,比起把模型训练成更会刷榜的「做题家」,混元更关心它到了真实场景里到底好不好用。
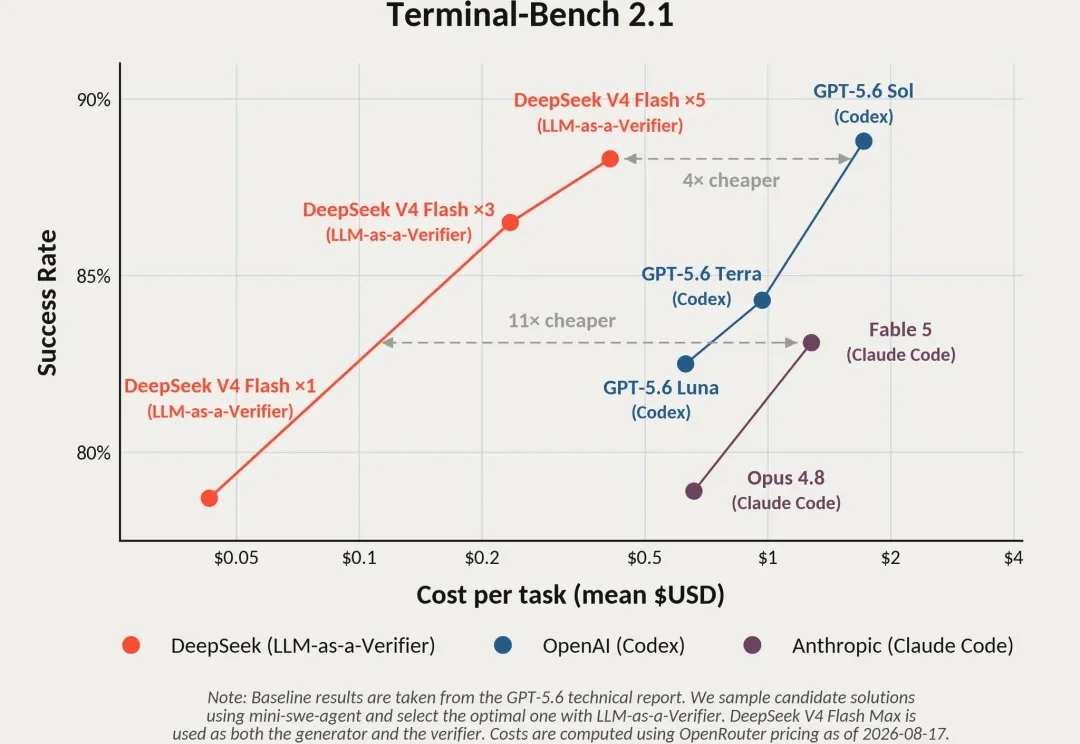
随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。
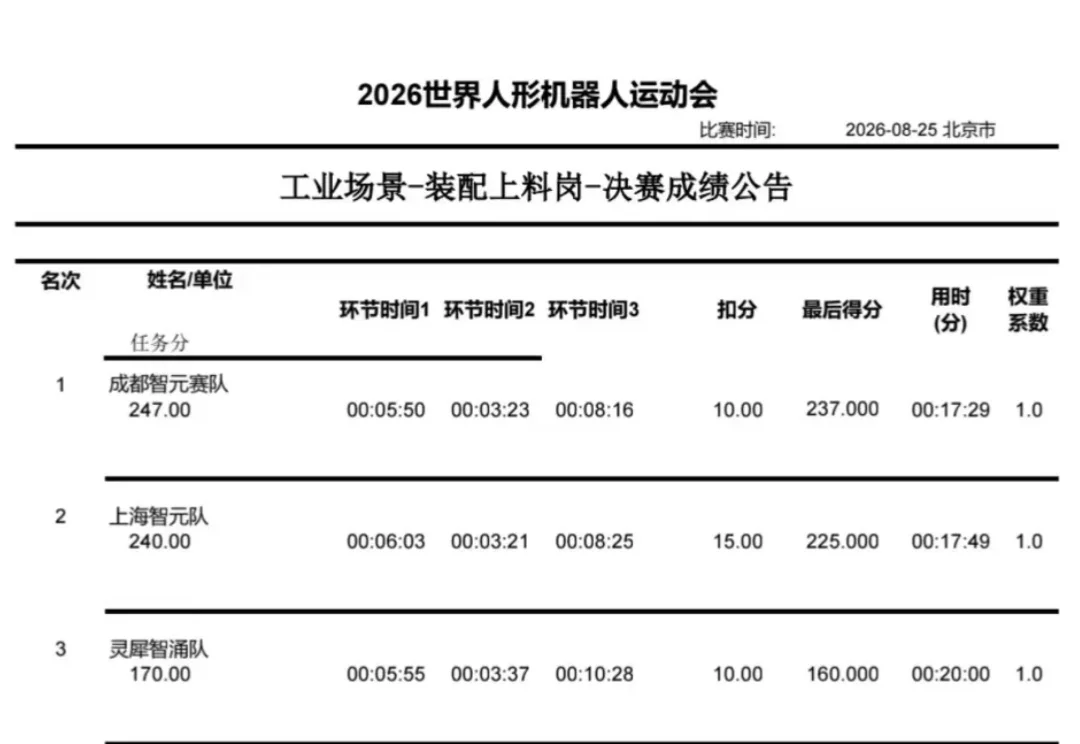
在 2026 世界人形机器人运动会 - 工业场景赛 -「装配上料岗」赛项中,一台机器人需要连续完成搬运上架、拣选上料、物料装配三项任务:从搬运 10kg 物料箱,到七类零件拣选,再到发动机 18 个气门的亚毫米级装配。
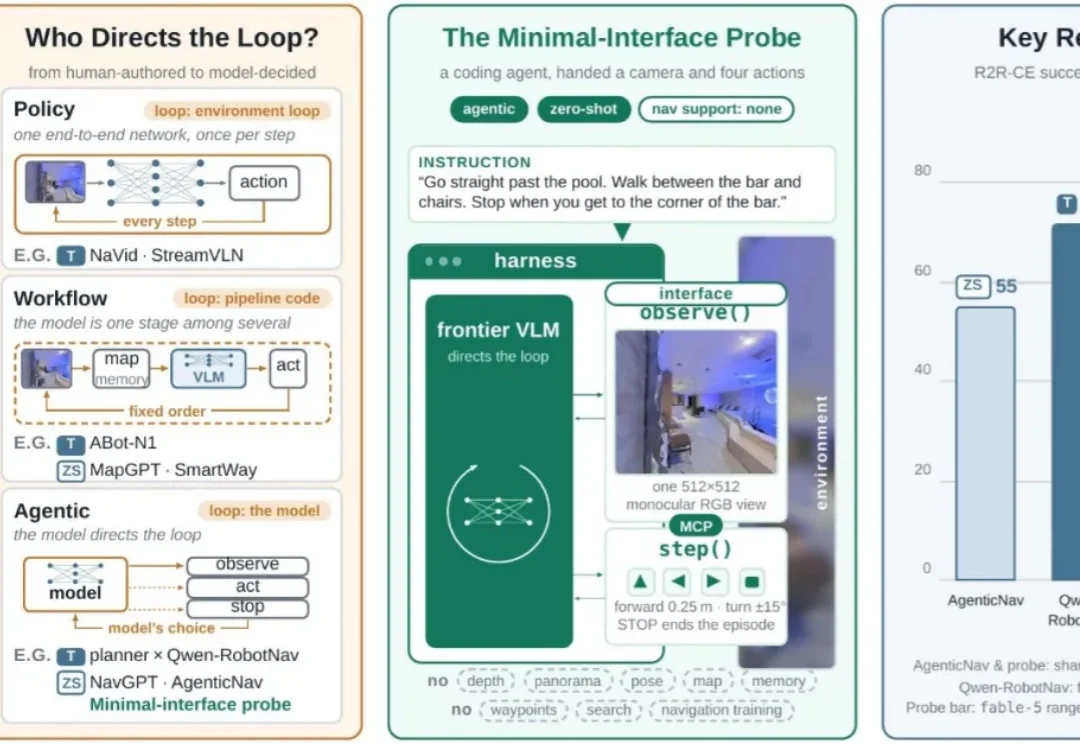
不建图、不记忆、零训练:coding-agent 被直接扔进屋里,导航成绩反超工业级专用模型。
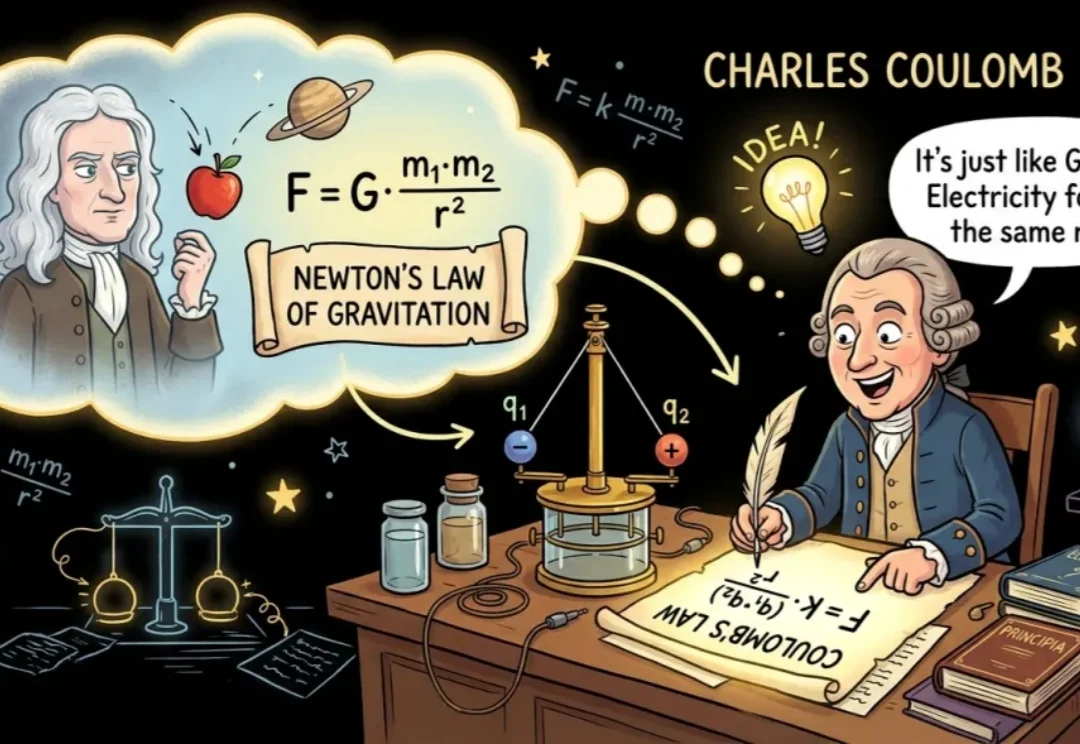
过去两年,大模型几乎重写了人机协作的默认想象:写代码、查资料、做分析,似乎都能 “一问即答”。但仔细看会发现,当下很多能力并不是模型自己长出来的,而是人为地在外面包了一层又一层框架。
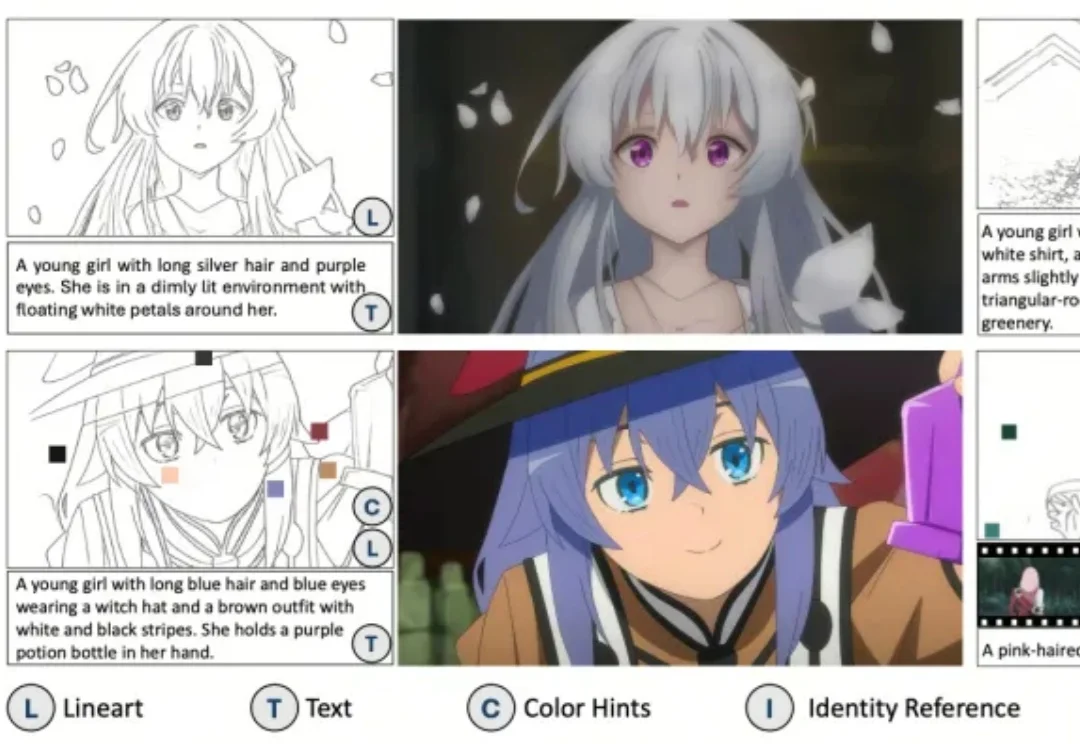
在动画和美术生产中,线稿上色是一个看似基础、却极其依赖细节控制的环节。创作者往往不是简单地把线稿涂上颜色,还需要理解角色身份、遵守局部色块约束、参考前后帧风格,并在连续片段中保持服装、发色、妆容和背景的一致性。
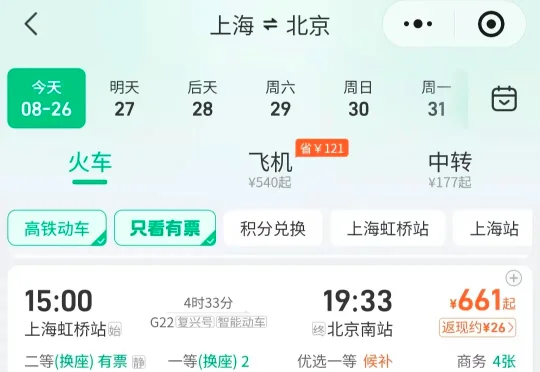
借助高效的相似方案召回,同程旅行不仅能按照用户的人数、时间、预算、座位约束条件找到最佳的直达线路;也能在直达票售罄的情况下,帮助用户快速找到如:车内换座直达、短换乘时间等替代方案。
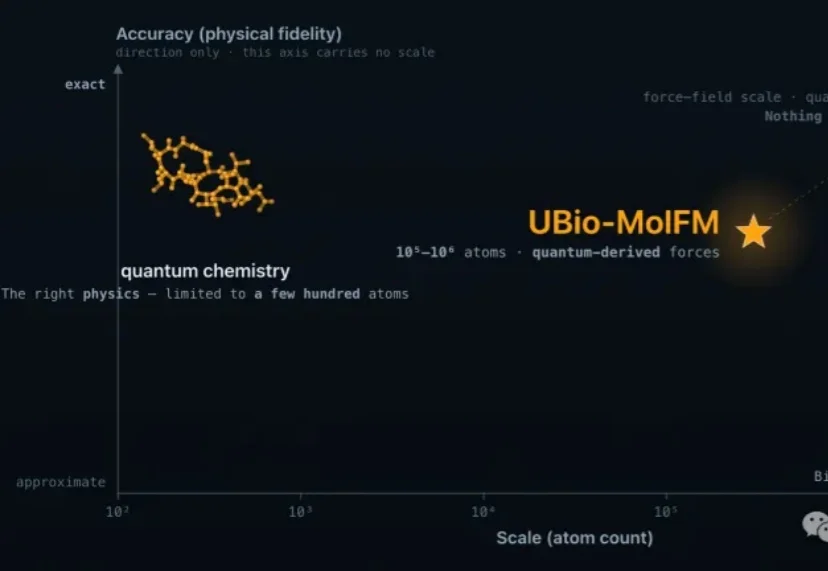
人类距离真正理解生命还有多远?