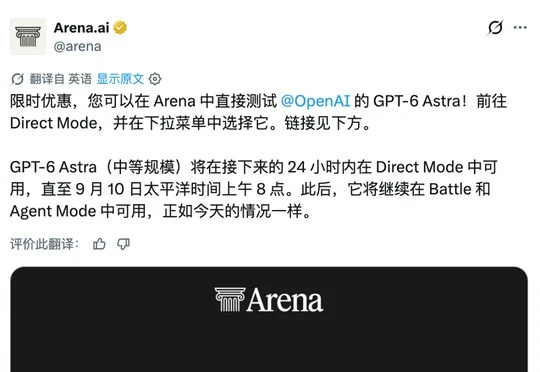
GPT-6 Astra,限时免费!我已爽玩
GPT-6 Astra,限时免费!我已爽玩AI大模型评测平台Arena宣布用户可在直接模式中限时免费使用GPT-6 Astra(仅限medium级别),大量开发者涌入体验开发游戏,目前该模型在Agent Arena榜单中整体排名第二、前端网页开发排名第一。
来自主题: AI资讯
9419 点击 2026-09-10 15:44

 搜索
AI大模型评测平台Arena宣布用户可在直接模式中限时免费使用GPT-6 Astra(仅限medium级别),大量开发者涌入体验开发游戏,目前该模型在Agent Arena榜单中整体排名第二、前端网页开发排名第一。
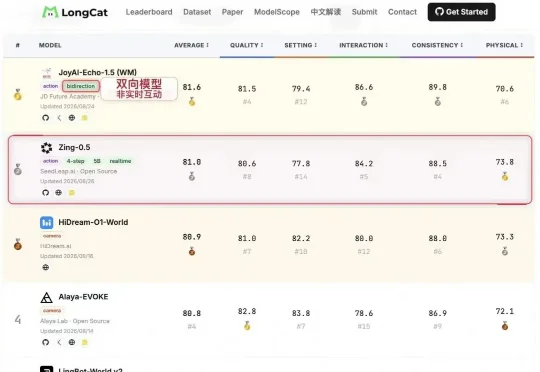
Loopit发布了实时互动世界模型Zing-0.5,在美团LongCat与复旦大学联合推出的可交互视频世界模型评测WBench中拿到第一。目前已经开源,并计划在2周内在Loopit APP(海外版)上线对应产品功能。

希望能做一个各个模型评分排行的汇总,方便实时了解和对比各种模型的性能。这个是一个非常有趣、且对我自己非常刚需的需求。因为现在的模型评测排行榜、评测集等等,实在是太多太多了,人人其实都可以做一份自己的评测集,然后来跑一份模型排行榜,有的测的全一些,有的就是个垂直场景的特定任务,这个量级真的特别大。
话不多说,直接开始每日瘫坐(doge)!
WorldArena 1.0 的核心意义,在于将世界模型评测从 “好不好看” 推进到 “是否真的有用”。它不再只关注视频观感,而是把物理一致性、可控性、3D 准确性和具身任务功能性纳入统一评测框架,使许多看似流畅的生成结果第一次在机器人具身任务中接受检验。
来自哈佛大学、MIT、IBM、波士顿大学、谷歌、JHU、CMU 和 Kempner Institute 的研究者提出了一个新的诊断性基准:MemoBench。这是首个面向动态环境的「消失-重现」世界建模评测基准,并已被计算机视觉顶会 ECCV 2026 接收。其一作 Haoyu Chen 为哈佛大学计算科学与工程专业一年级硕士生,师从哈佛大学计算机科学助理教授 Yilun Du。
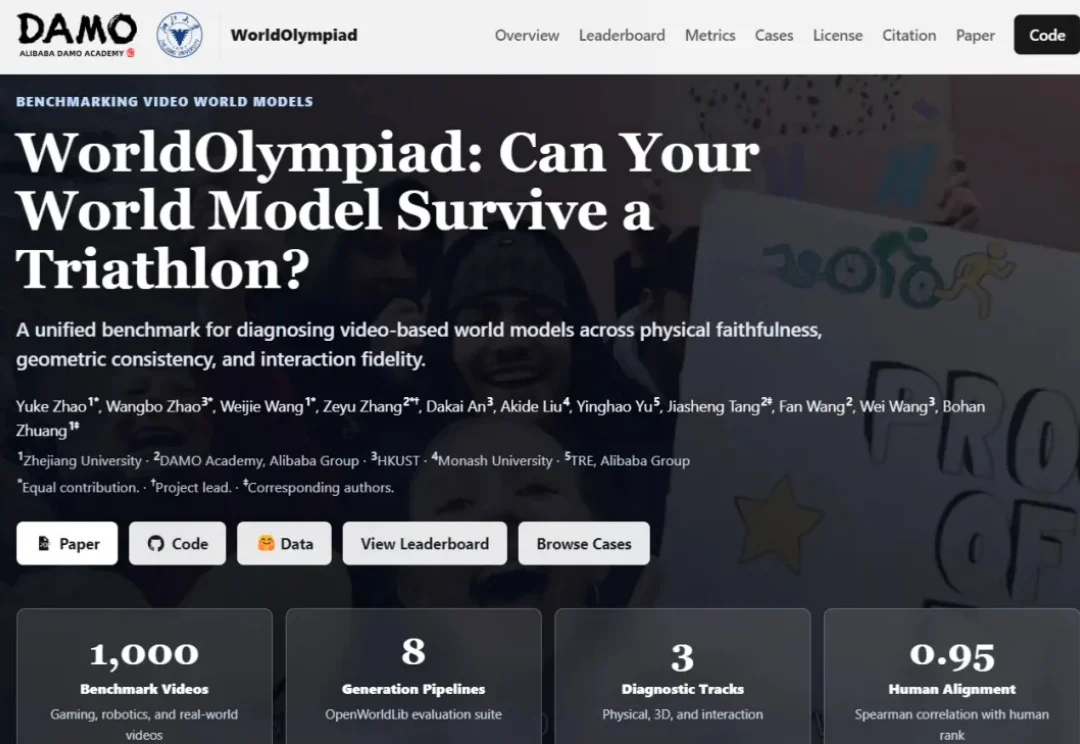
达摩院联合高校推出WorldOlympiad评测基准,跳出传统视频“唯画质”的评价逻辑,以物理真实性、三维几何一致性、长时序交互保真度三大维度,搭配游戏、机器人、通用实景三大场景,打造一套全方位的视频世界模型评测体系。
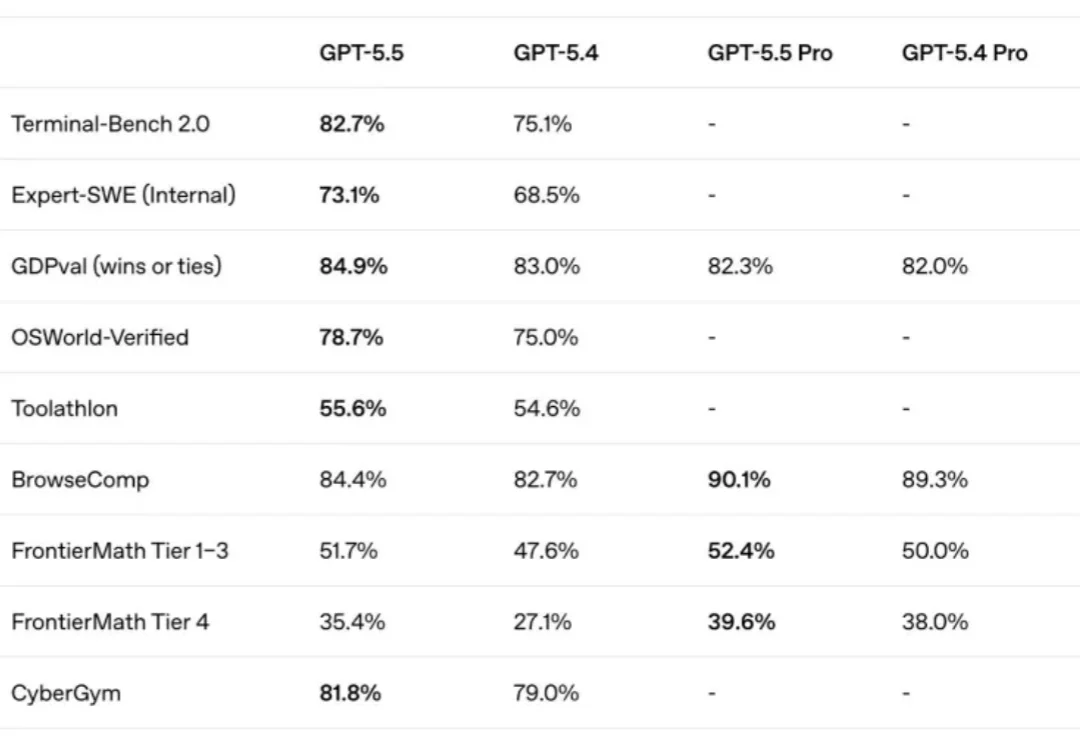
随着大语言模型逐步进入复杂推理、自动化研究和网络安全等高难度任务,传统的模型评测方式正在面临新的挑战。
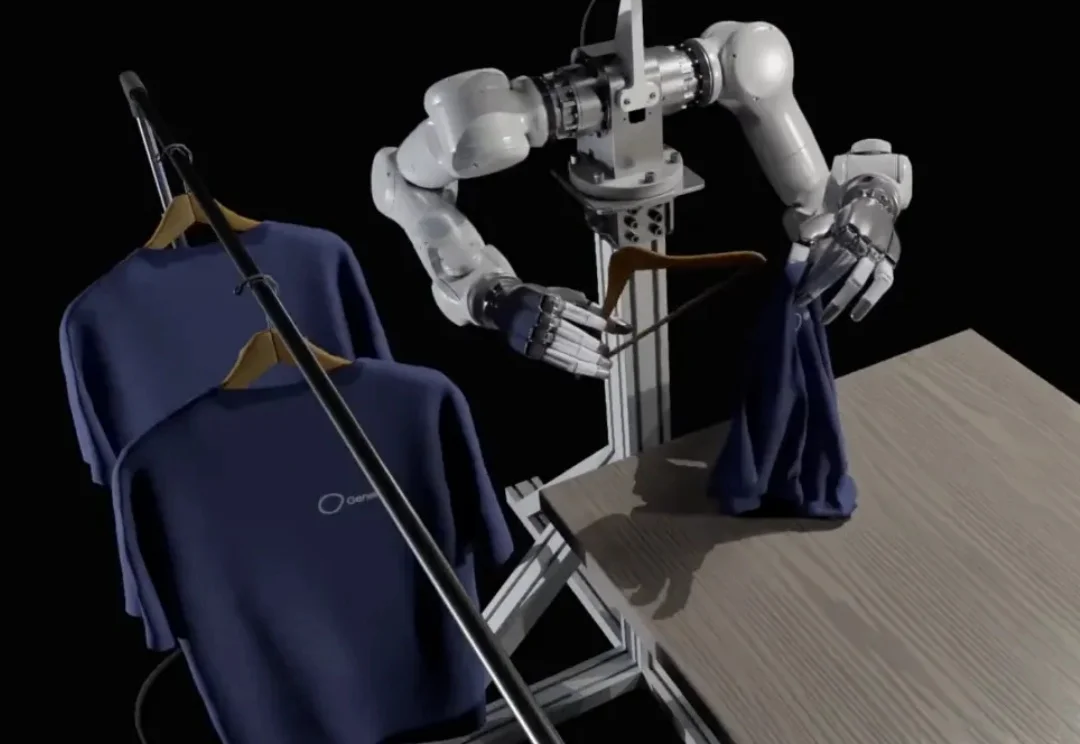
真实世界需要 200 多个小时的模型评测任务,可以在仿真中不到 0.5 小时内完成。
从去年开始做这个账号以来,我其实写过不少测模型的文章。我相信也有很多朋友是因为看了我测评的文章关注我的。但从过年之后,真的就很少写模型评测的文章了。主要是我写文章的速度甚至一度跟不上模型发布的速度了。