AI资讯新闻榜单内容搜索-生成模型

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 生成模型
独家|Soul将推出Loxinity,为自研语音、视觉与多模态交互产品

独家|Soul将推出Loxinity,为自研语音、视觉与多模态交互产品

独家|Soul将推出Loxinity,为自研语音、视觉与多模态交互产品

《读佳》独家获知,Soul将推出专为交互场景打造、超具活人感的语音合成产品“Loxinity(洛希无限)”,和市面上面向配音、短视频的TTS不同,这套模型从底层瞄准实时交互场景,主打强活人感。它支持单人配音、多人对话两种模式,配套音色克隆、音色设计等工具,还开放API接入。Loxinity下辖语音合成模型Loxi Speech和视频生成模型Loxi Avatar。

来自主题: AI资讯
7595 点击    2026-10-27 14:31
视频生成也能代码驱动了,Code Video Model来了

视频生成也能代码驱动了,Code Video Model来了

视频生成也能代码驱动了,Code Video Model来了

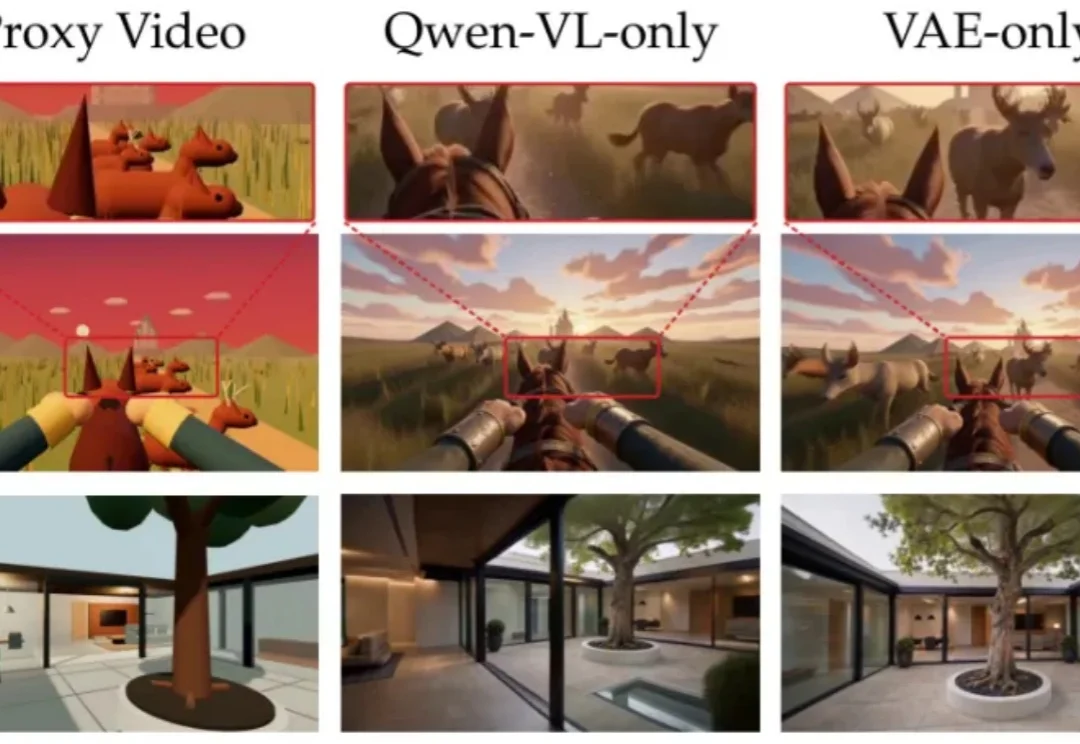
视频生成模型的视觉质量不断提升,但当前主流视频扩散模型仍面临两项根本局限。第一是物理规律约束不足:模型从像素中学习世界的视觉表象,却缺少物理方程的显式约束,画面看似合理,实际却不符合物理规律。

来自主题: AI技术研报
8780 点击    2026-10-26 11:12
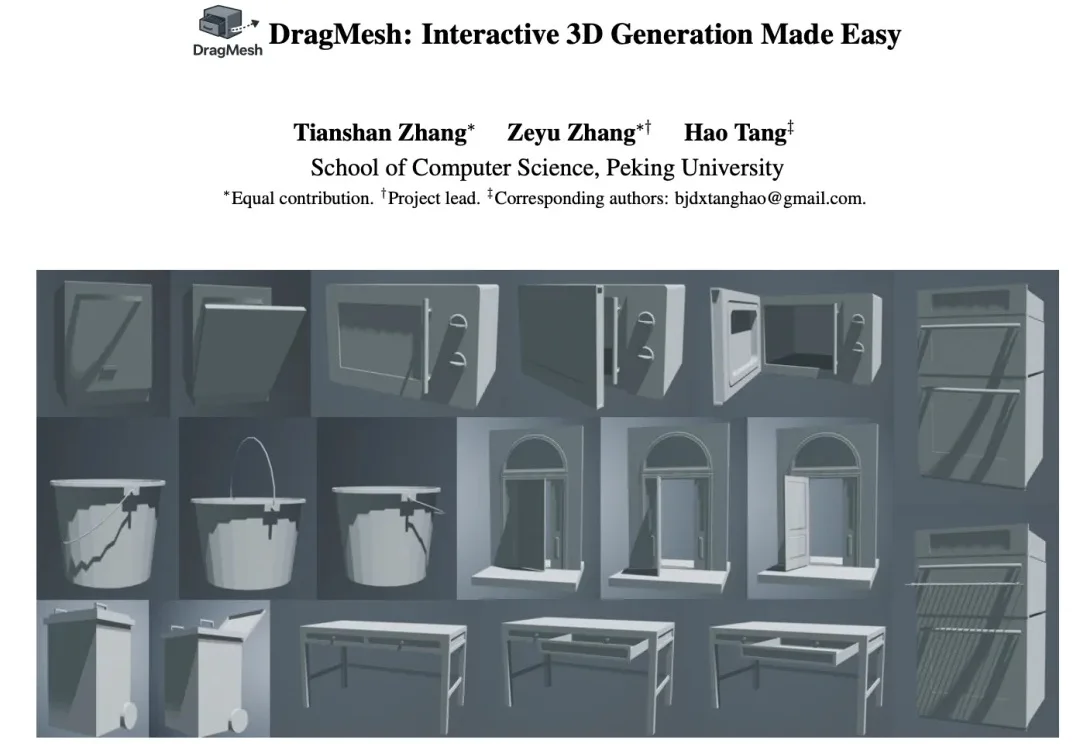
IJCV 2026|北大团队提出DragMesh:一次拖拽,实现可交互的3D关节运动生成

IJCV 2026|北大团队提出DragMesh:一次拖拽,实现可交互的3D关节运动生成

IJCV 2026|北大团队提出DragMesh:一次拖拽,实现可交互的3D关节运动生成

近年来,3D 生成模型在几何质量和渲染效果上进步很快。从 Mesh 到 NeRF、3D Gaussian Splatting,生成一个外观完整的三维物体已经不再困难。现有不少 articulated 3D generation 工作,更多关注的是从输入中生成一整套可动 3D 资产,包括物体几何、部件划分以及关节结构。

来自主题: AI技术研报
10472 点击    2026-10-22 10:09
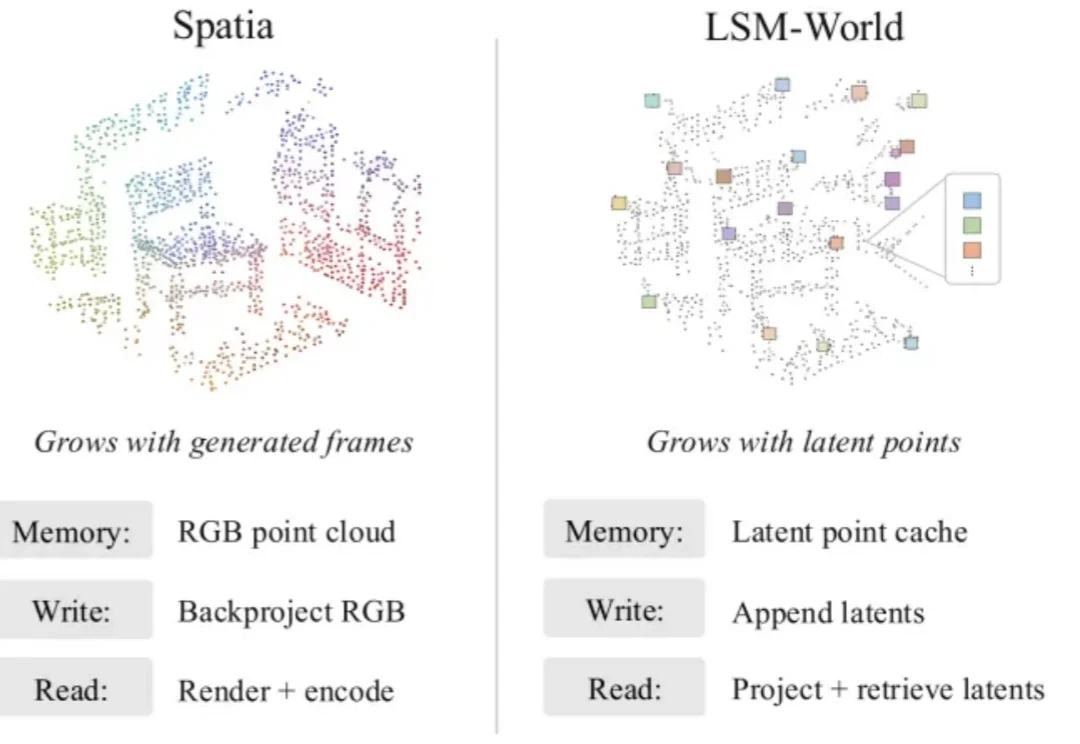
当视频模型回到原点,它还认得这里吗?Honeycomb用恒定大小记忆守住长视频的一致性

当视频模型回到原点,它还认得这里吗?Honeycomb用恒定大小记忆守住长视频的一致性

当视频模型回到原点,它还认得这里吗?Honeycomb用恒定大小记忆守住长视频的一致性

让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?

来自主题: AI技术研报
10317 点击    2026-10-15 12:04
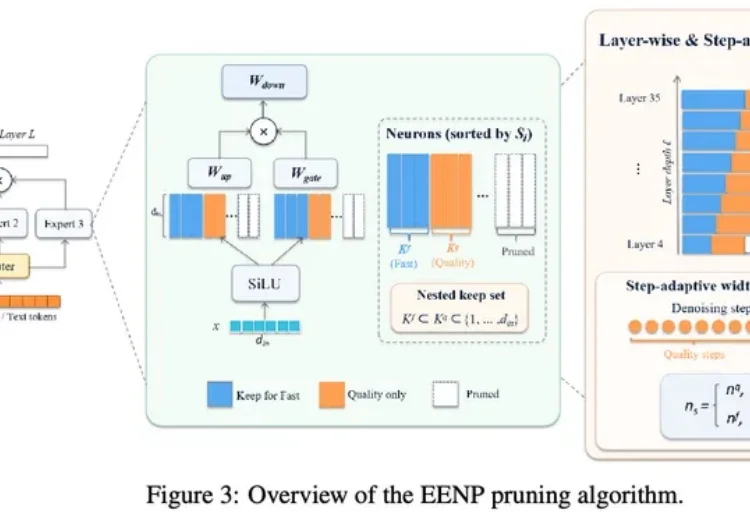
Dense 改 MoE、剪枝再提速:Agnes 开源 287 亿参数音视频生成模型

Dense 改 MoE、剪枝再提速:Agnes 开源 287 亿参数音视频生成模型

Dense 改 MoE、剪枝再提速:Agnes 开源 287 亿参数音视频生成模型

AI 视频越来越逼真,生成它的算力却并不便宜。复杂的动作、连贯的镜头和细腻的画面,背后都需要大量计算。一旦进入批量制作,反复生成、修改和重试的开销便会累积,成为创作者与视频平台必须考虑的成本。

来自主题: AI资讯
9593 点击    2026-10-14 12:14
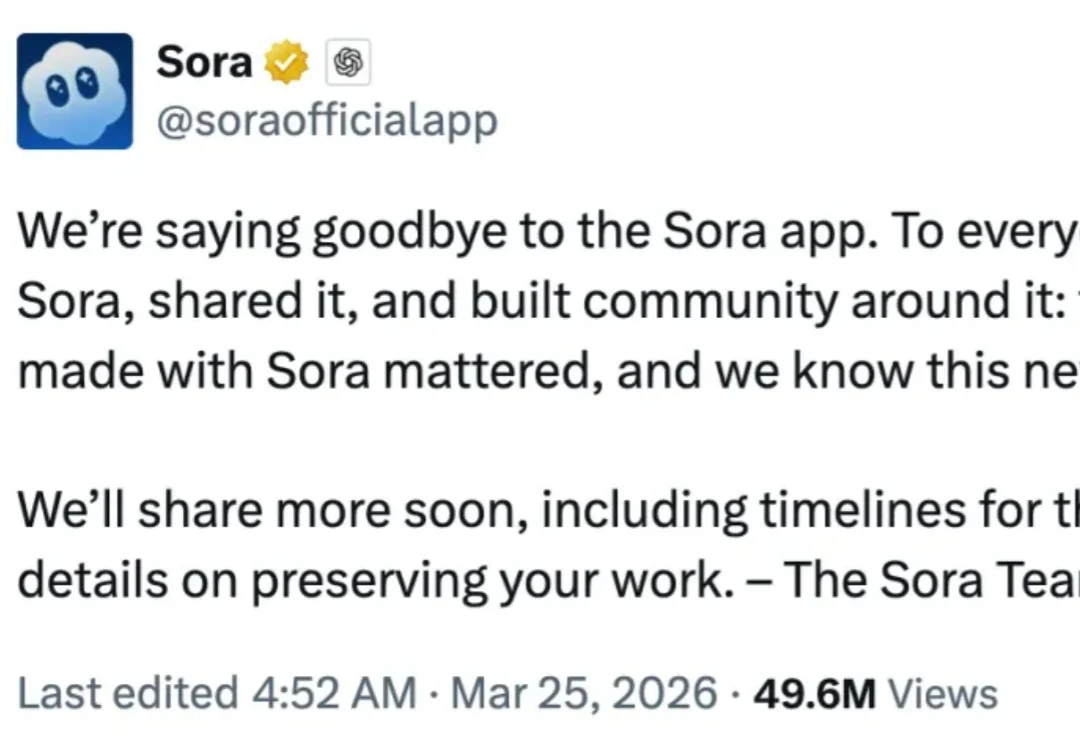
关停半年后,OpenAI要复活Sora?

关停半年后,OpenAI要复活Sora?

关停半年后,OpenAI要复活Sora?

刚刚,一则消息让已经被 OpenAI 放弃的视频生成模型 Sora,再次回到公众视野。

来自主题: AI资讯
8847 点击    2026-10-13 14:24
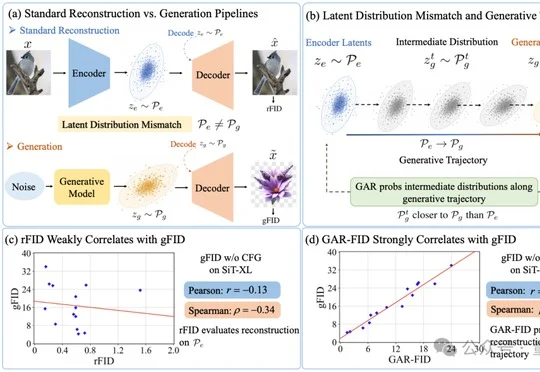
图像生成模型调优新思路:让解码器“提前适应”生成器的潜变量

图像生成模型调优新思路:让解码器“提前适应”生成器的潜变量

图像生成模型调优新思路:让解码器“提前适应”生成器的潜变量

让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。

来自主题: AI技术研报
9761 点击    2026-10-10 12:34
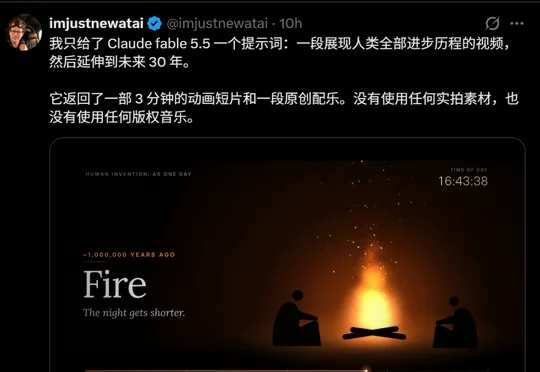
Fable 5.5震撼首测:人类万年史浓缩进24小时!外网传疯了的3分钟神作

Fable 5.5震撼首测:人类万年史浓缩进24小时!外网传疯了的3分钟神作

Fable 5.5震撼首测:人类万年史浓缩进24小时!外网传疯了的3分钟神作

今天,外网被这个视频刷屏了。有人用Fable 5.5一键生成了一部「人类数万年进化史」,把整个人类历史压缩进了3分钟。整个过程,都是用纯代码写出,零视频素材,零版权音乐,没有使用任何视频生成模型。

来自主题: AI资讯
9493 点击    2026-10-05 23:53
淘宝TaoMate-H3开源:三步生成「分钟级」音视频连续创作

淘宝TaoMate-H3开源:三步生成「分钟级」音视频连续创作

淘宝TaoMate-H3开源:三步生成「分钟级」音视频连续创作

TaoMate-H3 是由阿里巴巴 TaoLive AIGC 团队研发的音视频联合流式生成模型。基于 MiniMax H3,TaoMate-H3 将三步 LoRA 推理与自回归生成相结合,能够根据文本

来自主题: AI技术研报
8237 点击    2026-10-02 12:46
可灵憋了8个月,放出一只“参数怪”:30秒一镜到底,10个关键帧,HDR和双声道也来了

可灵憋了8个月,放出一只“参数怪”:30秒一镜到底,10个关键帧,HDR和双声道也来了

可灵憋了8个月,放出一只“参数怪”:30秒一镜到底,10个关键帧,HDR和双声道也来了

可灵AI发布时隔8个月大版本更新的旗舰视频生成模型Kling 4.0及轻量版Kling 4.0 Flash,单次原生生成时长提升至30秒,最多支持10个关键帧输入,新增双通道立体声输出,并将很快推出4K 10-bit HDR格式。

来自主题: AI资讯
9412 点击    2026-09-29 11:52