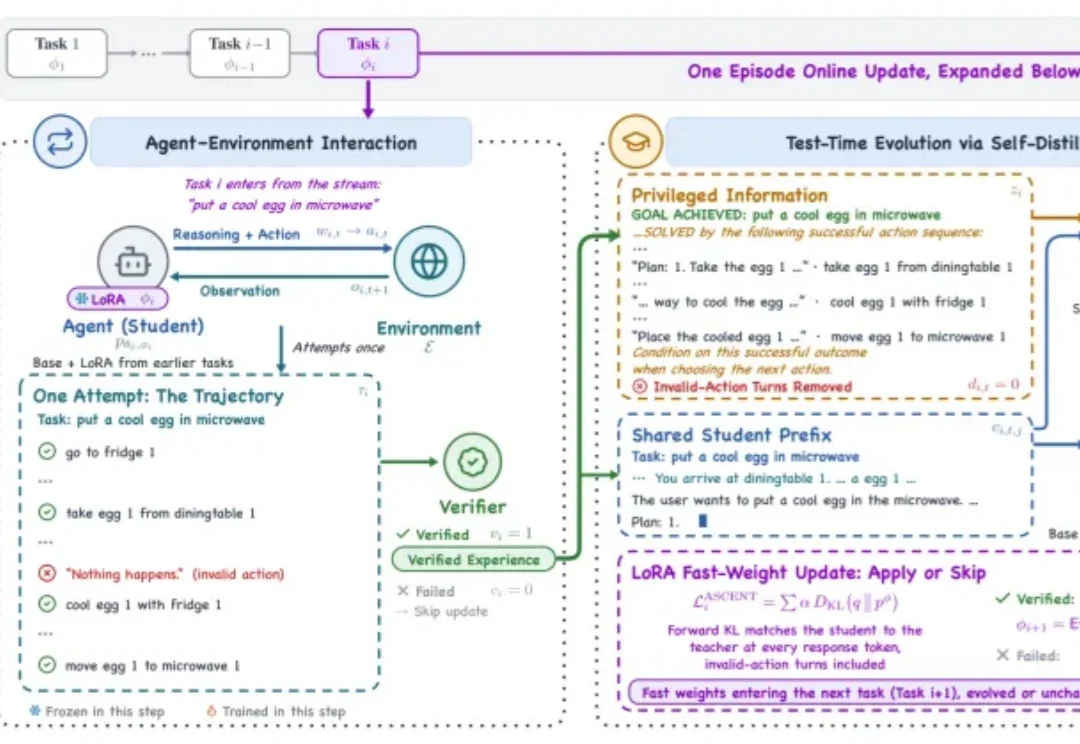
AI终身学习新解法:成功经验自蒸馏进权重,交互轮数直接减半
AI终身学习新解法:成功经验自蒸馏进权重,交互轮数直接减半LLM智能体如何在部署过程中,通过自身执行持续进化?
来自主题: AI技术研报
6642 点击 2026-10-27 09:49

 搜索
LLM智能体如何在部署过程中,通过自身执行持续进化?
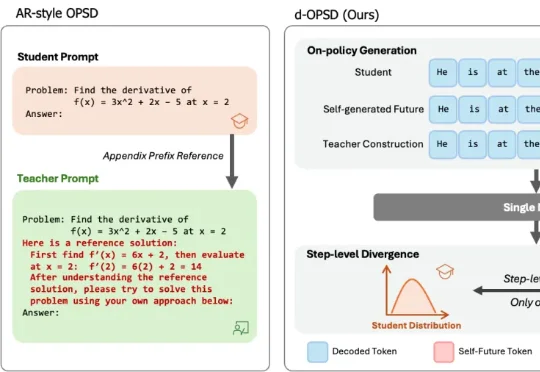
有没有一种更为合适的 OPSD 范式?近期,清华大学和马普所等机构的研究者们联合推出的 d-OPSD,给这一问题提供了完美的答案。这是第一个针对扩散大语言模型的 OPSD 范式,无需参考解,无需额外的教师模型,只需要 RL 十分之一的训练步数,便可以达到或超出 RL 的后训练效果。
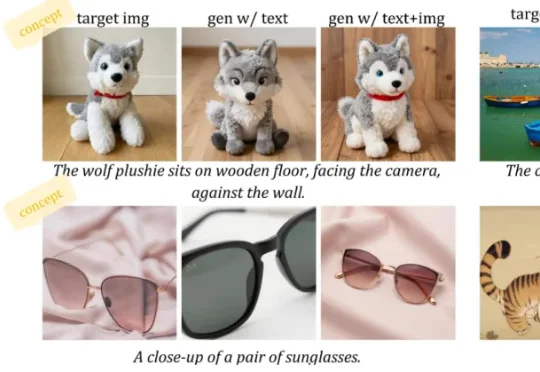
阿里巴巴 Z-Image 团队联合香港科技大学、加州大学圣地亚哥分校、香港中文大学等机构提出 D-OPSD(On-Policy Self-Distillation),首个针对少步扩散模型的在线策略自蒸馏框架。D-OPSD 无需奖励模型、无需成对偏好数据,
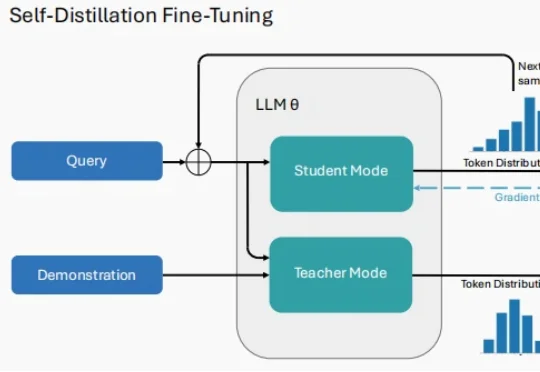
2026 年刚拉开序幕,大模型(LLM)领域的研究者们似乎达成了一种默契。 当你翻开最近 arXiv 上最受关注的几篇论文,会发现一个高频出现的词汇:Self-Distillation。

张林峰于2019年提出了自蒸馏算法,是知识蒸馏领域的代表性工作之一。DeepSeek出现后,知识蒸馏领域再次获得了极大的关注。
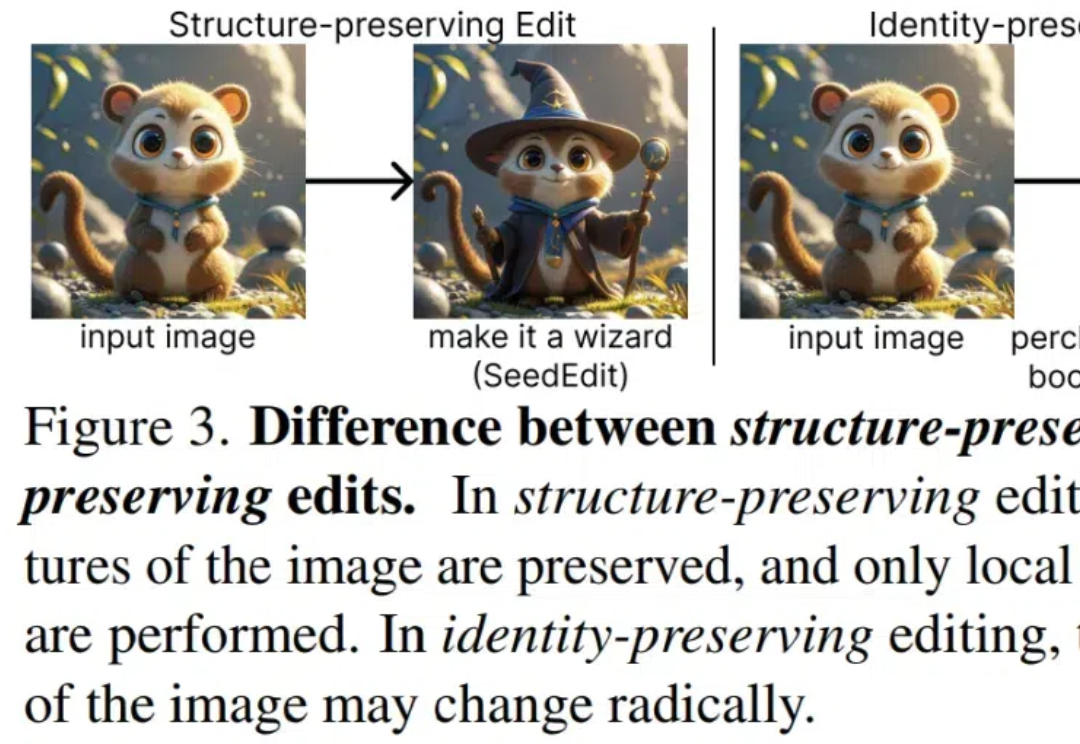
近年来,文本到图像扩散模型为图像合成树立了新标准,现在模型可根据文本提示生成高质量、多样化的图像。然而,尽管这些模型从文本生成图像的效果令人印象深刻,但它们往往无法提供精确的控制、可编辑性和一致性 —— 而这些特性对于实际应用至关重要。