清华、英伟达等开了个新榜,38个AI实时视频模型露短板
清华、英伟达等开了个新榜,38个AI实时视频模型露短板清华大学、英伟达等机构联合推出全球首个流式交互视频生成评测榜单StreamEval,以300个用例评测38个模型,揭示当前模型在连续指令执行和状态一致性方面仍存明显短板。
来自主题: AI技术研报
10076 点击 2026-10-27 13:40

 搜索
清华大学、英伟达等机构联合推出全球首个流式交互视频生成评测榜单StreamEval,以300个用例评测38个模型,揭示当前模型在连续指令执行和状态一致性方面仍存明显短板。
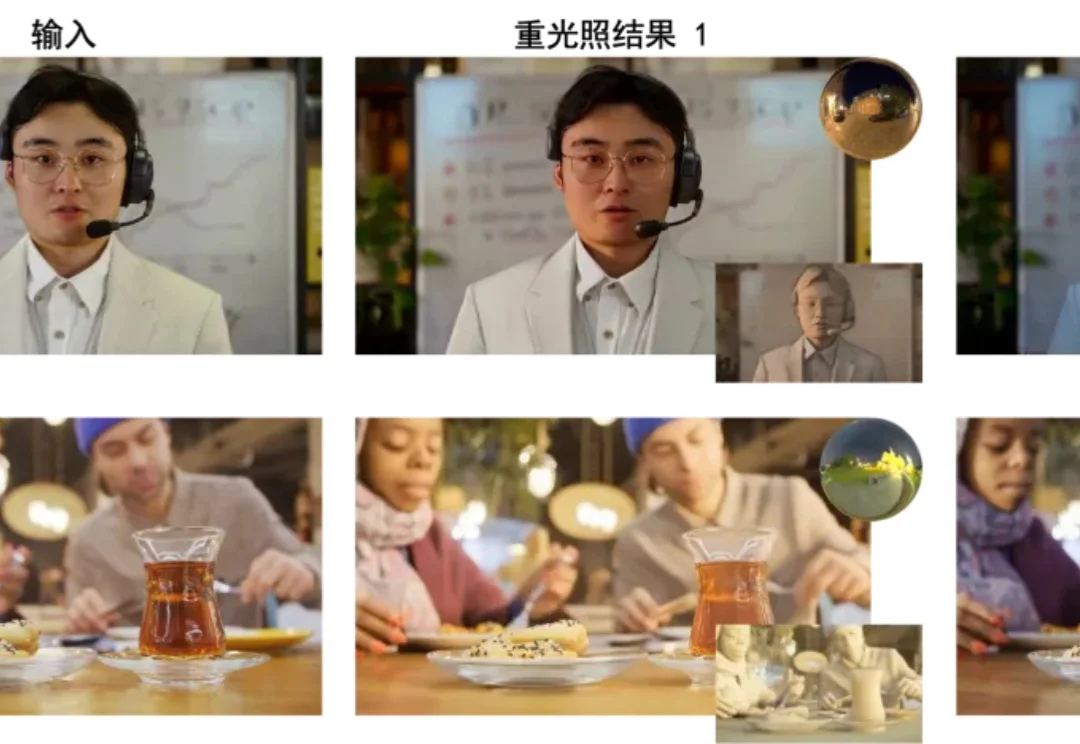
世界模型希望让机器理解环境如何变化,并预测干预后的结果,支持智能体学习、仿真与内容创作。这要求视频模型在场景变化时仍保持物理关系的一致性。光照是其中关键的一环:当光源移动,人物、物体与阴影应协同响应。可控重光照由此成为探索视频模型物理表达能力的切入点。
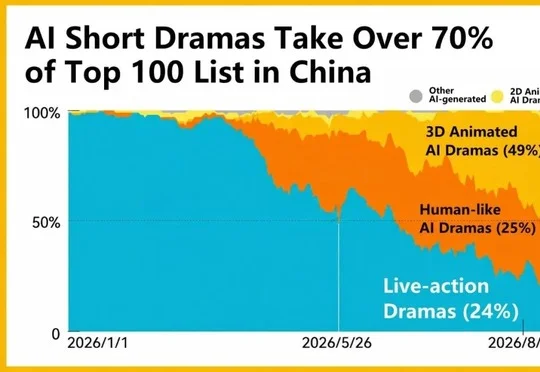
文章指出,AI短剧消耗国内55% Token和占据一半算力的说法并不准确,但其快速增长正创造新增推理需求,并推动视频模型与算力基础设施扩张。
这一周的AI视频圈,简直是神仙打架。
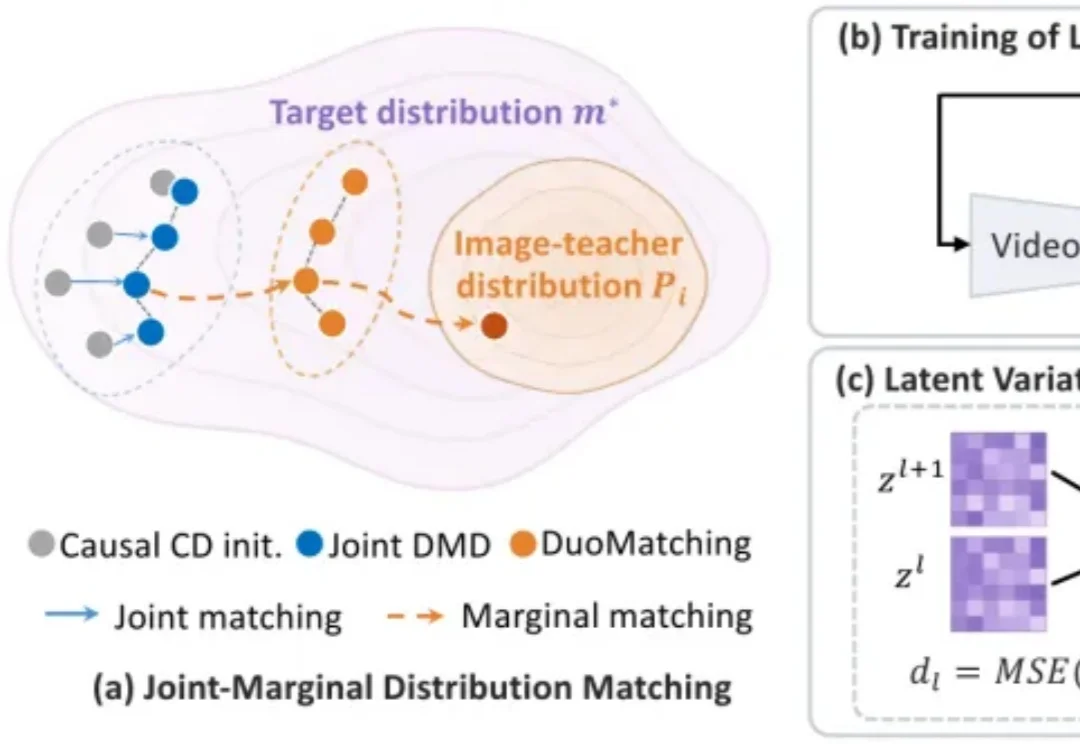
在视频生成领域,少步视频模型已经实现只需少量采样步骤,就能生成连续画面。
今天,可灵AI在凌晨的时候,终于正式上线了他们最新的视频模型Kling 4.0。
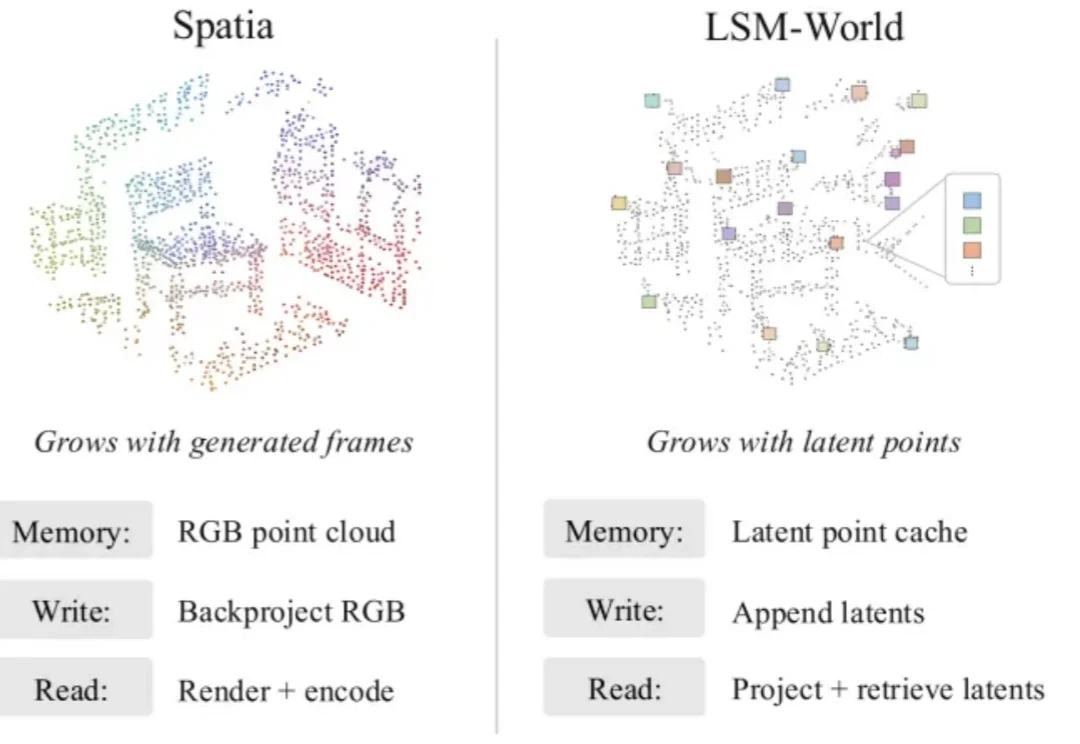
让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?
英伟达联合MIT和牛津大学团队提出Physis-Lang,通过物理语言描述、自进化准则和能力导向的数据检索提升视频模型的物理理解与生成表现,其Cosmos3-Super和Cosmos3-Nano在Physics-IQ Verified分列第一、第二。
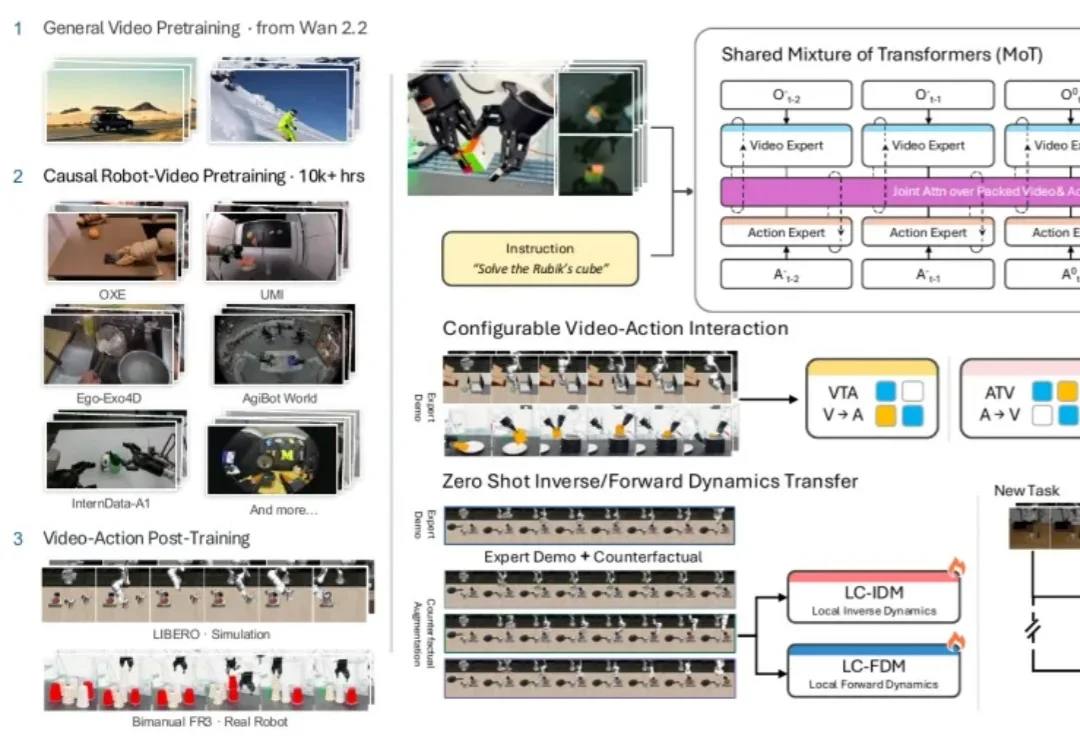
9 月 22 日,以 FLUX 图像模型闻名的 Black Forest Labs 跨界发布了开源 7B 世界动作模型 FLUX 3 Action。据其官方博客,该模型在英伟达 RoboLab-120 榜单上超过了此前最强的开源模型 Cosmos 3 Nano,参数量却不到后者一半。一家做图像生成的公司跑来卷机器人控制,说明视频模型里积累的「物理直觉」正被越来越多的团队当作机器人大脑的底座。
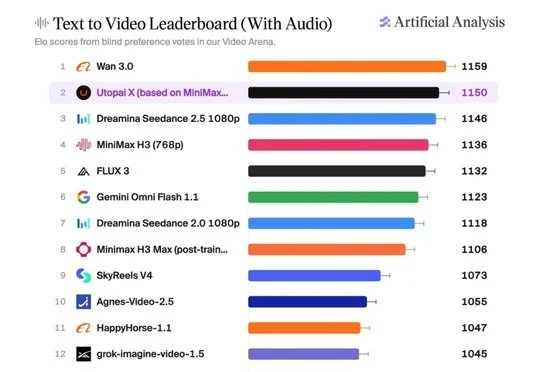
Utopai Studios打造的Utopai X在Artificial Analysis Video Arena盲评中以1150 Elo位列全球第二,其核心竞争力是将模型深度集成PAI制作系统,并通过真实影视项目、专家反馈与系统迭代形成持续进化的数据飞轮。