
Fish Audio:上海00后闷声干翻ElevenLabs
Fish Audio:上海00后闷声干翻ElevenLabsFish Audio(上海奇塔灵动科技)由00后廖世嘉带领22人团队,凭借开源语音模型Fish Speech在TTS Arena盲听榜连续7个月第一,年化收入达2100万美元,2026年7月获今日资本领投5200万美元种子轮。
来自主题: AI资讯
7765 点击 2026-09-12 10:00

 搜索
Fish Audio(上海奇塔灵动科技)由00后廖世嘉带领22人团队,凭借开源语音模型Fish Speech在TTS Arena盲听榜连续7个月第一,年化收入达2100万美元,2026年7月获今日资本领投5200万美元种子轮。

8 月 4 日,腾讯混元正式发布新一代语音识别模型 Hy ASR 3.0 preview。基于最新一代大语言模型 Hy3 的语言理解能力,Hy ASR 3.0 preview 融合高精度语音识别与深度语义理解能力,在通用识别、上下文感知、多场景鲁棒性以及方言覆盖等核心维度实现全面提升,
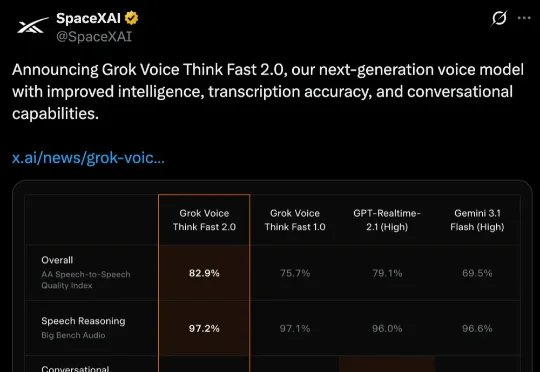
今日,马斯克旗下SpaceXAI宣布推出新一代语音模型Grok Voice Think Fast 2.0,这是该公司迄今能力最强的语音到语音(speech-to-speech)模型。马斯克连发两条推文,第一条宣布“Grok Voice现在在智能体性能方面排名第一”,第二条则直接喊话网友“试试新的Grok Voice”。
就在刚刚,OpenAI 正式推出了全新一代语音模型 GPT-Live。正如它的名字一样,这一次,ChatGPT 的语音功能彻底「活」了过来。据官方透露,目前每周有超过 1.5 亿人使用 ChatGPT 的语音和听写功能来练习外语、讲睡前故事或在通勤时打发时间。而从今天起,这 1.5 亿人将迎来一次豆包式的进步:
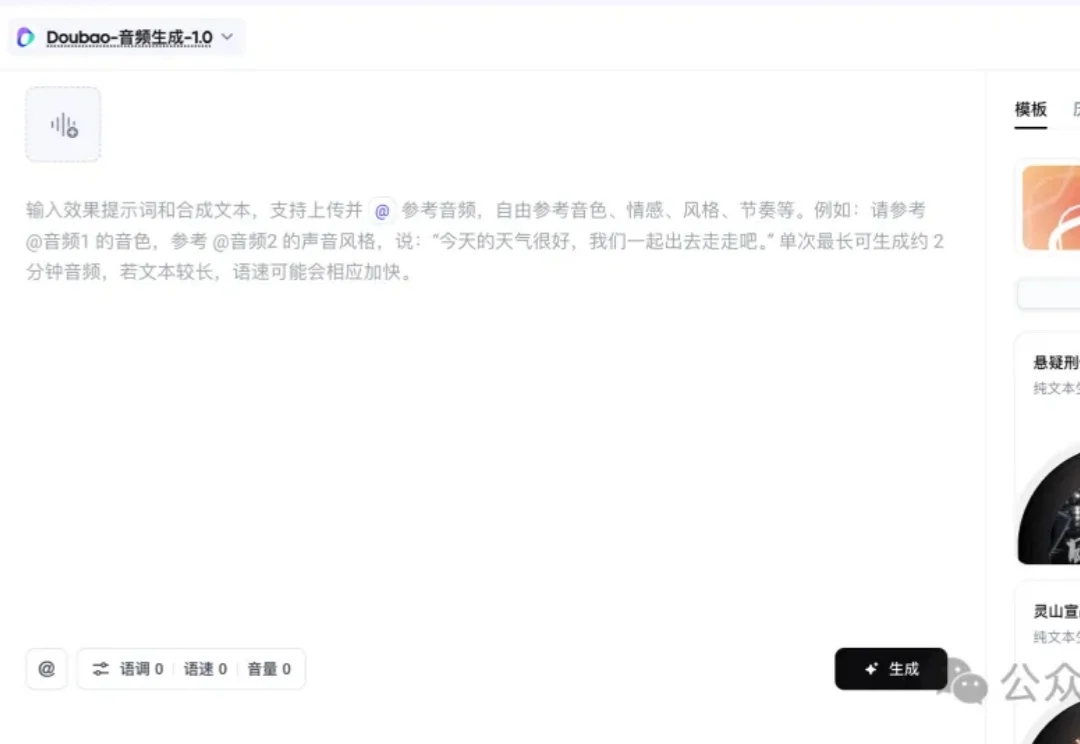
火山引擎今天上线了全新的语音模型—— 豆包音频生成模型 1.0(Seed-Audio 1.0)。
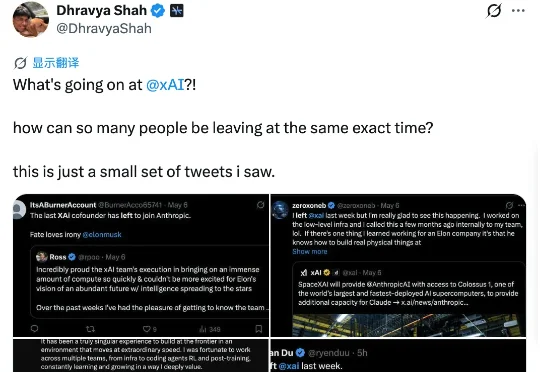
刚刚,xAI再失一名华人大将。就在今天,预训练负责人庄钧堂官宣了自己的离职消息。此前,庄钧堂已经在xAI工作了两年。这期间,他主导了从Grok 2到Grok 5的全系列预训练,同时负责Grok在X和Tesla上的语音模型及xAI企业API模型。
不知道大家平时有没有这种经历。
阶跃星辰今日发布新一代自动语音识别模型StepAudio 2.5 ASR。该模型面向语音转写与长音频处理场景,在架构上引入Multi-Token Prediction(多Token预测)以提升推理效率,并通过扩展上下文窗口强化长内容识别能力。
看到标题《这个模型让机器人长出了嘴》,你可能会心生疑惑: AI不是早就懂语音播报了吗?
语音合成大家都不陌生,这两年市面上各种AI配音也层出不穷。